Métodos modernos asistidos por IA
Del DAG al método · DiD revolution · Lab L4 pair programming · Gancho Mona Lisa + 4 Sprints + 🏁 H3 asincrónico
Universidad EAFIT · Escuela de Finanzas, Economía y Gobierno
19 de noviembre de 2026
Bienvenidos
Unidad 6 — Métodos modernos asistidos por IA
Sesión 6 · jue 19/11 · 3h online · 18:00–21:00
Nota
Pregunta guía: ¿Qué método responde mi pregunta de identificación dado mi DAG H2 · y cómo escribo código auditable con IA como copiloto?
Lo que se lleva esta sesión:
- ✅ DAG -> Cuestión
- ✅ Lab L4 (pair programming) iniciado en clase
- ✅ Veredicto Replication Court entre pares
- 🏁 H3 PAP moderado + Lab L4 · entrega asincrónica dom 22/11 · 23:59
🎨 El gancho · ¿Qué hipótesis querés estimar?
De la hipótesis que el DAG H2 dibujó · al método que te permite estimarla bien
¿Qué hipótesis querés estimar?
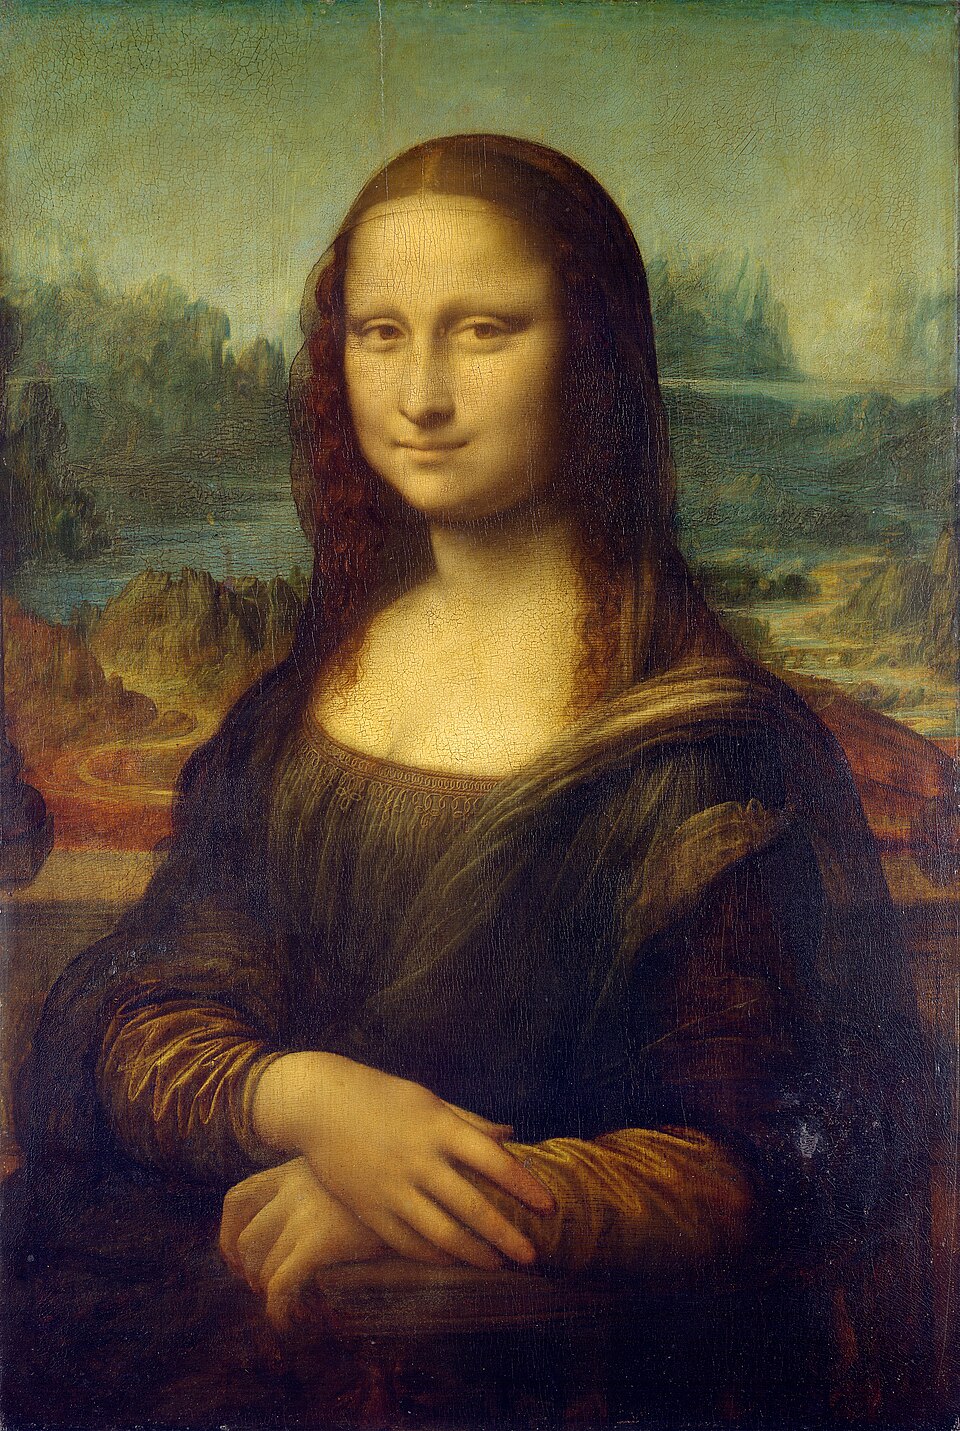
Esto es lo que tu DAG H2 dice que querés estimar.
Tu hipótesis primaria, causal o de otro tipo, define el rostro que perseguís.
- Salieron de S05 con esta hipótesis mapeada al DAG.
- No es la versión idealizada · es la que la realidad permite identificar.
- Hoy vemos qué pasa cuando llegan los datos y empieza el choque.
→ Antes de elegir método: ¿saben qué hipótesis están persiguiendo?
Pero con los datos · granularidad gruesa
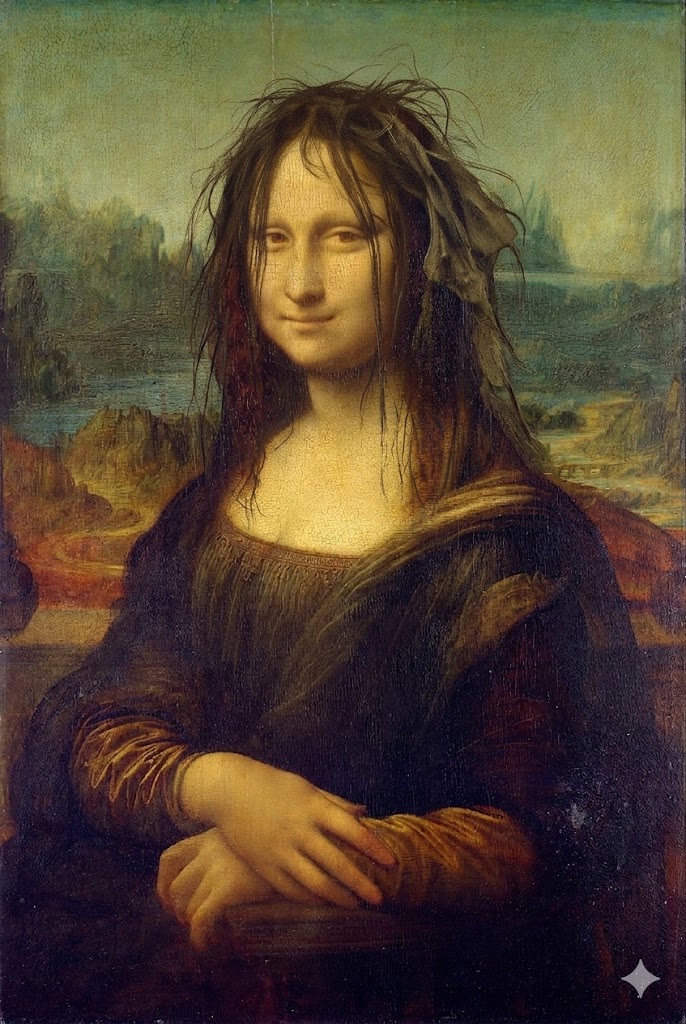
Pero los datos llegan así.
Panel trimestral, no mensual · censo cada 4 años · municipio, no barrio.
- Granularidad temporal/espacial gruesa = solo ves manchas de color.
- No podés separar efecto instantáneo de dinámica.
- Pre-trends invisibles a baja frecuencia.
→ La data limita lo que el método puede ver. El rostro existe — pero acá no se distingue.
Pero con los datos · especificación errada
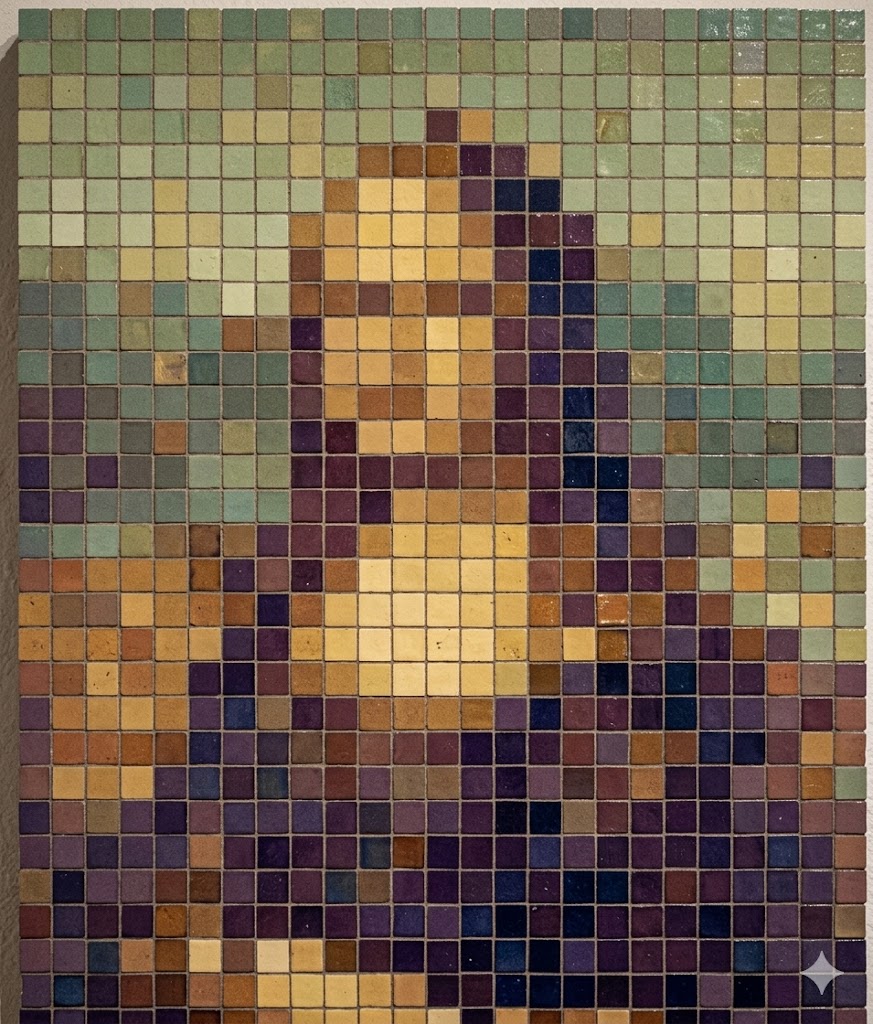
Pero los datos tienen tratamiento escalonado.
Y vos aplicaste TWFE clásico — peinado de 2026 sobre cuadro de 1503.
- Técnicamente “corre”.
- (Goodman-Bacon, 2021): pesos negativos · puede dar el signo equivocado.
- El resultado se ve plausible — pero no es la cara que perseguías.
→ La especificación tiene que empatar con la estructura del tratamiento. Misma data, distinta cara.
Pero con los datos · sobre-controlado
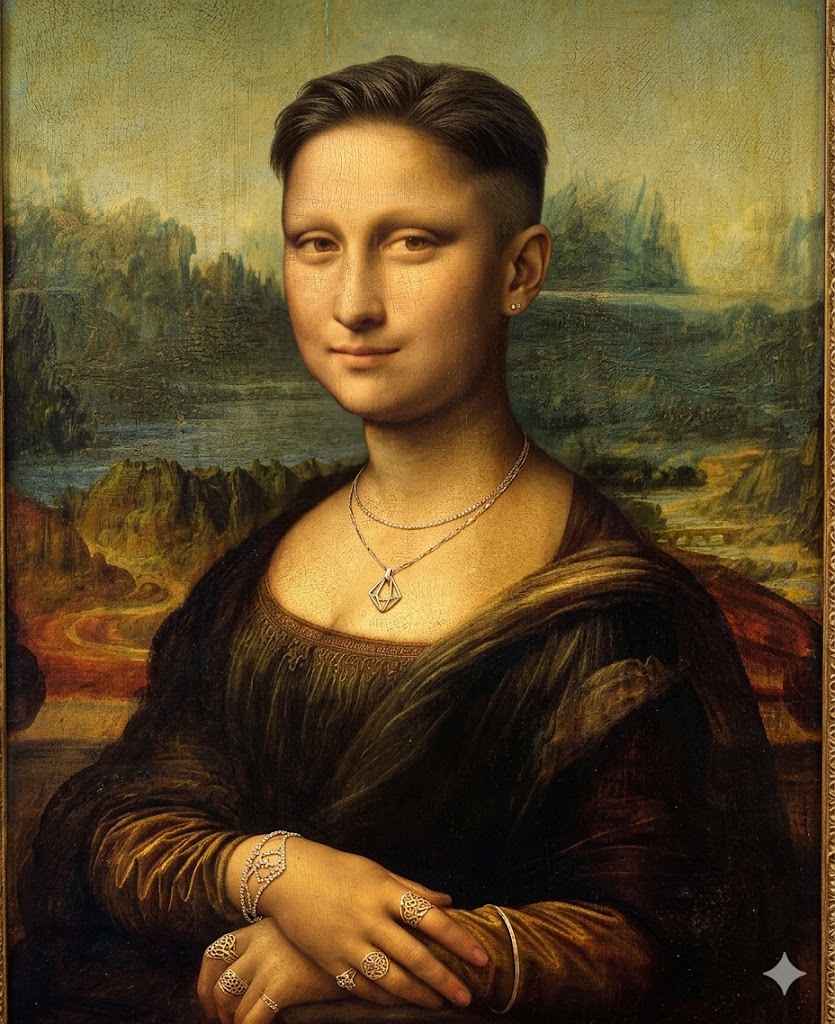
Pero los datos tienen muchas variables.
Y vos “le metiste todos los controles que tenías, por las dudas”.
- Controles post-tratamiento → cierran el canal causal.
- Colliders → abren backdoor que estaba cerrado.
- Bad controls (Cinelli et al., 2024) deforman · no limpian.
→ El DAG decide qué entra al modelo. No la intuición del investigador.
Y lo que con disciplina sí podés estimar
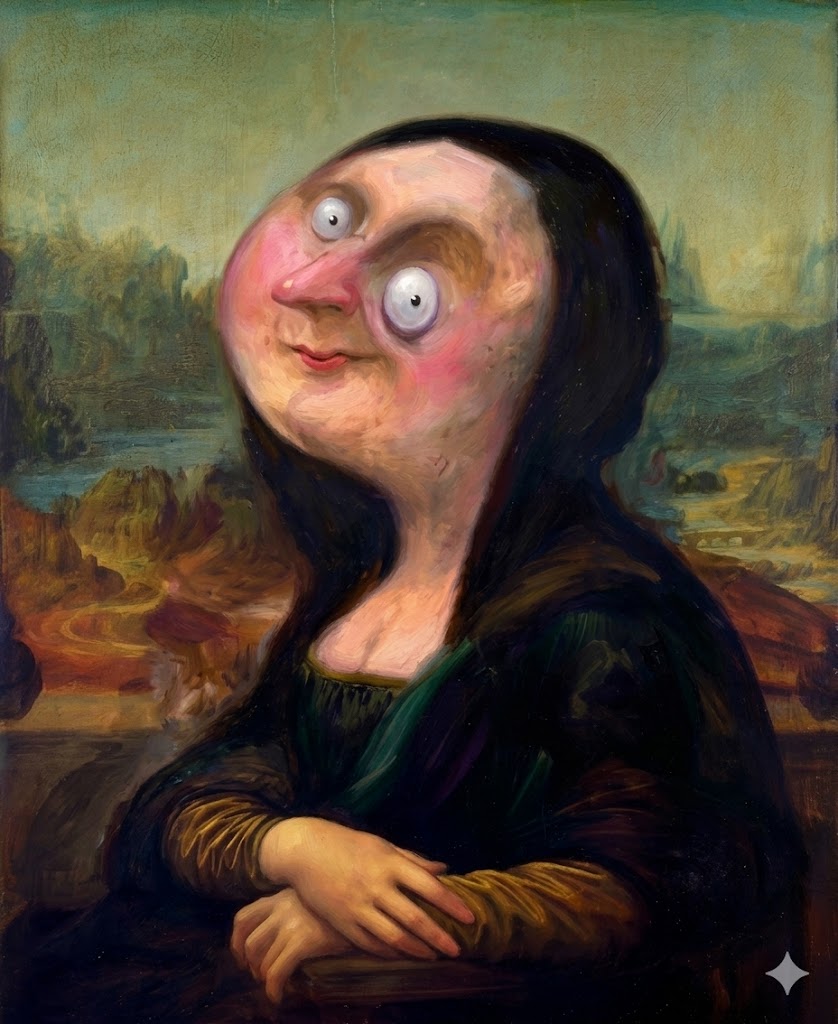
Esto es lo que SÍ podés estimar.
Cuando datos · DAG · método empatan, llegás a un coeficiente identificable · defendible · replicable.
- Mismo DAG · mismos datos · método disciplinado.
- ATT identificado · pre-trends diagnosticados · ≥2 estimadores.
- No es perfecto, pero es honesto sobre lo que es.
→ Esta es la estimación que puedes defender.
La tesis de U6 · el método depende
El método NO se elige.
El método depende.
| Depende de… | Decisión que fija |
|---|---|
| Tus datos | Granularidad temporal · balance · missings · variación |
| Tu DAG (H2) | Qué backdoor cerrar · qué controlar · qué ignorar |
| Tu pregunta | ATT promedio · heterogeneidad · mecanismo · contrafactual |
| La estructura del tratamiento | TWFE clásico · staggered · synthetic · IV · RDD |
Cómo trabajamos hoy — 3h online · 4 Sprints
| Bloque | Qué hacemos | JC | Act | Fin |
| Sprint 0 · 🎤 | Standup post-H2 + montar el proyecto IA² | 5 | 10 | 18:15 |
| Sprint 1 · 🎯 | Del DAG al método · 4 JC + 4 ejemplos | 30 | 15 | 19:00 |
| ☕ Break | Lejos de la pantalla | 10 | 19:10 | |
| Sprint 2 · 🤝 | Lab L4 · pair programming en las 2 parejas | 15 | 45 | 20:10 |
| Sprint 3 · ⚔️ | Replication Court · 4 rondas, una por estudiante | 5 | 35 | 20:50 |
| Cierre | Roadmap del H3 asincrónico + pregunta de cierre | 5 | 5 | 21:00 |
Total: 180 min. El Sprint 4 (lockdown del H3) se hace en casa hasta dom 22/11 · 23:59.
Regla: AIAS 4 auditado. La IA escribe; ustedes auditan línea por línea. Sin audit log no hay entrega.
El bridge · H1 + H2 + DAG → 🏁 H3 PAP moderado
El jueves pasado entregaron H1 (PRON · OG · OE). El martes cerraron Sprint B con H2 (Evidence Map + DAG + hipótesis). Hoy abrimos Sprint C — DESIGN & DEFENSE: el DAG ya eligió el método; ahora hay que escribir el código que ese DAG implica y defender la identificación contra el escrutinio de pares.
PRON 2 págs
OG + 3 OE · 15%
Evidence Map
+ DAG · 20%
DiD revolution
elegir estimador
Lab L4 Pair
Programming
Replication
Court
PAP moderado
+ Lab L4 · 20%
Sprint 0 · 🎤 Standup
5 JC · 10 Act · Check del DAG H2 + ¿qué método sospechás? + montar proyecto IA² (4 espacios)
📍 Estructura del Sprint 0 (15 min)
🎓 Check del DAG H2 + cuál es el método indicado (5 min)
Consejo
El método no se elige por moda — se elige por:
- Pregunta (asociativa · interventiva · contrafactual — Pearl ladder)
- DAG (qué backdoors hay · qué se puede bloquear)
- Datos (panel · cross-section · longitudinal · texto)
- Honestidad (qué supuestos podés defender)
Advertencia
Trampa pedagógica: “voy a usar DiD porque es lo que aprendí”. ❌ Eso es la herramienta determinando la pregunta. El DAG decide; vos sólo defendés esa decisión.
🧩 Del DAG a la hipótesis verificable al método (puente U5 → U6)
El DAG quedó dibujado. Hoy lo traducimos en 3 pasos a un método auditable. Cada arista es una hipótesis verificable que el método debe poder testear.
X → Ycon dirección + signo esperado- Confounders
Zidentificados - Backdoor paths marcados
- Cita Evidence Map por arista
- 🎯 Dirección (X aumenta · disminuye Y)
- 📏 Magnitud (banda esperada · efecto mínimo detectable)
- ⚙️ Mecanismo (vía qué mediador opera)
- 🎚️ Condicionalidad (cuándo deja de aplicar)
- Estimador primario justificado por DAG
- Cross-check con estimador alternativo
- Placebos y sensitivity que testean la arista
- Especificación pre-registrada en PAP
🧩 Puente · cont. · de Mill 1843 al DAG
Consejo
Linaje epistemológico (resumen brutal · 180 años):
| Año | Aporte | Hoy se ve como |
|---|---|---|
| 1843 Mill · A System of Logic | Canon positivo + negativo + método de la diferencia | Lógica del contrafactual · counterfactual reasoning |
| 2000 Pearl · Causality | DAGs + do-calculus + backdoor criterion | Formalización del canon de Mill |
| 2021 Goodman-Bacon | TWFE decomposition · pesos negativos | Stress test del método cuando el DAG es panel staggered |
→ El DAG no es invento de moda · es Mill 1843 con sintaxis 2000 y diagnóstico 2021.
Advertencia
Causalidad ≠ correlación (recordatorio operativo):
“Las implicaciones causales provienen del razonamiento conceptual (teoría) en lugar de la evidencia empírica.”
→ El DAG es ese razonamiento conceptual hecho explícito. El método sólo testea lo que el DAG ya dijo que es testeable. Si tu método “descubre” causalidad que el DAG no implicaba → estás haciendo p-hacking, no inferencia.
🤖 ¿Qué cambia hoy? · Lab L4 ≠ Lab L3 (3 min)
Inversión de roles desde el Lab L3 (S05, martes · DAG):
- Dirige — define qué hay que implementar
- Audita — cada línea de código que la IA escribe
- Verifica — corre tests · cross-check con ≥2 estimadores
- Decide — aceptar · rechazar · editar la sugerencia
- Documenta — audit log denso con prompt + decisión
- Implementa — boilerplate · sintaxis · paquetes
- Propone — alternativas de especificación · diagnósticos
- Explica — qué hace cada línea cuando preguntás
- Refactoriza — limpia código cuando lo pedís
- NUNCA decide identificación · controles · supuestos
Modo AIAS dominante hoy:
⭐ HOY
(Perkins et al., 2024): modo 4 = operativa auditada. La IA produce salida útil; el humano se queda con la responsabilidad de la decisión. Si la IA escribió tu regresión y vos no podés explicar cada línea → ese código no es tuyo.
🛠 Montar el proyecto para trabajo empírico con IA (10 min · Act)
Antes de escribir código con IA, el proyecto necesita 4 espacios. La carpeta es la interfaz que tu IA lee cada vez que la invocas.
tesis/
├── data/      ⛔ gitignored
│   ├── raw/
│   └── processed/
├── code/      📜 numerado
│   ├── 01_clean.R
│   ├── 02_did.R
│   └── 99_robust.R
├── output/    📊 regenerable
├── audit/     📝 L1–L5
├── prompts/   💬 reproducible
├── docs/      📖 PAP · DAG · README
└── Makefile
CLAUDE.md/.cursorrulesen raíz- Contexto pegado: pregunta · DAG · método elegido · convenciones
- Qué NO hacer (ej: no usar TWFE clásico)
DECISIONS.md· log alto nivel- DAG H2 visible (PNG en
docs/)
audit/L4-pair-programming.md(línea por línea)audit/decisions.md(giros metodológicos)audit/AIAS-report.md(modo por tarea)audit/errors-IA.md(≥1 error detectado)- Markdown vivo, NO chat efímero
set.seed(2026)en cada scriptsessionInfo()/renv.lock/requirements.txtMakefile:make allreproduce todo.gitignore:data/raw/*,.env,.DS_Store- Plantillas:
PAP.md
🛠 Montar el proyecto · cont. · la tarea (10 min)
Tarea concreta (10 min · ahora):
git initentesis-apellido/Crear las 7 carpetas +
.gitignore+Makefilevacío.Escribir
CLAUDE.md/.cursorrules: pregunta H1 · arista principal del DAG · tipo de tratamiento · datos · modo AIAS 4 · reglas duras (sin TWFE en staggered, audit log, 1 error de IA detectado).Inicializar
audit/L4-pair-programming.mdcon el encabezado.Commit inicial:
git commit -m "setup: project structure + AI memory".
Advertencia
Por qué importa: la estructura evita pegar archivos · la memoria evita que la IA invente convenciones · los audits rastrean cada decisión · la reproducibilidad hace que tu repo corra en el computador de JC el domingo.
Consejo
Plantillas listas: materiales/CLAUDE-template.md · materiales/Makefile-template · materiales/plantilla-PAP-moderado.md. Copialas, no las reinventes.
Sprint 1 · 🎯 Del DAG al método · identificación primero
30 JC · 15 Act · 45 min · Identificación → estrategias → 6 patrones DAG → patrón estrella · 4 ejemplos · tu decisión
📍 Estructura del Sprint 1 · 5 JC + actividad
🎓 JC 1/8 · ¿Qué es identificación causal? (4 min)
El problema fundamental (Holland 1986):
Nadie observa simultáneamente Y(1) e Y(0) para la misma unidad. El contrafactual no existe en los datos.
Identificar = recuperar E[Y(1) − Y(0)] (el ATT) a partir de datos donde solo vemos uno de los dos estados por unidad.
La pregunta operativa de Pearl:
Si dos unidades tienen el mismo valor de todos los confounders relevantes · pero distinto D · ¿por qué difieren en D?
Esa “razón por la que difieren” es la fuente de variación que identifica el efecto.
Consejo
Identificación ≠ estimación.
- Identificación: ¿bajo qué supuestos el ATT está bien definido dado lo que observo? Decisión de diseño.
- Estimación: ¿cómo computo numéricamente ese ATT? Decisión de software.
Si la identificación falla, la estimación más fina decora una pregunta sin respuesta.
Advertencia
Pregunta-control para tu DAG H2: mirando tu diagrama · ¿qué supuesto defendés para que el ATT esté identificado? Marcalo con un círculo. Eso es lo que vas a tener que defender el sáb 21/11.
🎓 JC 3/8 · 4 estrategias de identificación · respuestas al problema (5 min)
La idea central (Angrist-Pischke): una estrategia de identificación es una forma de aislar variación exógena de D — variación que existe independientemente de los confounders no observados.
| Estrategia | La idea | Endogeneidad que cierra | Supuesto clave |
|---|---|---|---|
| A · Conditioning | Comparo unidades con mismo valor de X observable | Solo tipo 1 si X observable | Selection on observables · backdoor cerrable |
| B · Instrumento (IV) | Uso Z que mueve D pero NO afecta Y directamente | Cierra tipos 1, 2 y 3 vía Z | Exclusion restriction · Z ⊥ Y | D, U |
| C · Discontinuidad (RDD) | Comparo unidades casi iguales a ambos lados de un umbral | Tipo 1 localmente · "as if random" | Continuidad de Y(0) en el umbral · no manipulación |
| D · Variación temporal (DiD) | Comparo cambio en tratados vs cambio en controles | Tipo 1 si U es time-invariant | Parallel trends · sin shocks diferenciados |
🎓 JC 3/8 · cont. · qué variación explota cada estrategia
El insight clave: cada estrategia explota un tipo distinto de variación para resolver un tipo distinto de endogeneidad. Conditioning asume que el confounder es observable ((Imbens, 2015) · (Oster, 2019)). IV asume que existe una palanca exógena ((Angrist et al., 1996) LATE · (Andrews et al., 2019) weak IV). RDD asume que un umbral institucional genera comparabilidad local ((Lee & Lemieux, 2010) · (Cattaneo et al., 2020)). DiD asume que los confounders no se mueven en el tiempo ((Roth et al., 2023)). Ninguna estrategia es universalmente mejor — el DAG H2 decide cuál aplica.
→ Próximo slide: cada estrategia tiene 1-3 implementaciones canónicas. Esos son los 6 patrones DAG + los métodos asociados. Lectura puente PO ↔︎ DAG: (Imbens, 2020) (JEL · Nobel 2021) — “the best work uses both”.
🎓 JC 4/8 · 6 patrones DAG canónicos · cuanti (8 min)
| # | Patrón DAG | Estructura mínima | Estrategia | Ejemplo típico |
|---|---|---|---|---|
| 1 | Randomización | R → D → Y sin backdoor |
Comparar medias entre brazos | RCT microcrédito · evaluación experimental |
| 2 | Selección sobre observables | D ← X → Y, X observable |
Condicionar en X (adjustment set) | Educación → ingreso controlando background familiar |
| 3 | Instrumento | U → D, U → Y, Z → D, Z ⊥ Y|D,U |
Explotar variación exógena Z | Distancia a universidad como instrumento de educación |
| 4 | Discontinuidad | D = 1[X ≥ c] |
Comparar alrededor del umbral c | Cesárea por umbral de peso · beca por puntaje |
| 5 | Variación temporal ⭐ | Panel · D se enciende en t* para algunos | Diferencias en diferencias (DiD) | 4G en Catatumbo · reforma educativa por cohortes |
| 6 | Alta dimensión observables | D ← X₁..Xₚ → Y, p grande |
ML para nuisance functions | Tratamiento heterogéneo en RCT grandes · políticas multinivel |
Regla operativa: identificá tu DAG H2 con uno de estos 6 patrones (o una combinación). El patrón 5 (variación temporal) es el más común en tesis MAE y el más subtle — le dedicamos el JC 6/8 completo. No toda tesis cabe en cuanti: el DAG también vive en cuali y mixto (JC 5/8, en el apéndice).
🎓 JC 4/8 · cont. · lecturas canónicas por patrón
Lecturas canónicas modernas por patrón (núcleo · todas con ficha):
- P1 Randomización — (Athey & Imbens, 2017) (handbook) · (Bruhn & McKenzie, 2009) (práctica) · (Banerjee et al., 2015) (microcrédito 6 RCTs)
- P2 Sel. observables — (Imbens, 2015) (JHR matching review) · (Iacus et al., 2012) (CEM) · (Oster, 2019) (sensitivity δ)
- P3 Instrumento — (Angrist et al., 1996) (LATE Nobel) · (Andrews et al., 2019) (weak IV modern) · (Mogstad et al., 2024) (frontera)
- P4 Discontinuidad — (Cattaneo et al., 2020) (libro moderno) · (Calonico et al., 2014) (Ecta CI robust) · (Lee & Lemieux, 2010) (JEL canon)
- P5 Variación temporal — (Roth et al., 2023) · (Goodman-Bacon, 2021) · (Callaway & Sant’Anna, 2021) · (de Chaisemartin & D’Haultfœuille, 2020) · (Sun & Abraham, 2021) · (Borusyak et al., 2024) · (Rambachan & Roth, 2023)
- P6 Alta dimensión — (Athey & Imbens, 2019) · (Chernozhukov et al., 2018) · (Wager & Athey, 2018)
🎓 JC 6/8 · Patrón estrella · variación temporal y Goodman-Bacon (8 min)
Por qué este patrón: es el más común en evaluación de políticas en LATAM. El DAG parece simple, pero el TWFE clásico falla con tratamiento escalonado.
El teorema demoledor de Goodman-Bacon 2021 (Goodman-Bacon, 2021):
Cuando hay tratamiento escalonado (distintos grupos tratados en distintos momentos) + efectos heterogéneos, el coeficiente TWFE es un promedio ponderado de comparaciones 2×2 con pesos negativos.
→ Implicación práctica: TWFE puede dar el signo equivocado de un efecto real.
did en R.DIDmultiplegt en Stata/R.Advertencia
Regla dura del aula: si tu DAG implica staggered DiD → NUNCA entregues TWFE sin haber corrido al menos 1 estimador moderno como cross-check. Brodeur 2020 (Brodeur et al., 2020) mostró que IV/DiD son los métodos más p-hackeados — el cross-check es la disciplina mínima.
🔧 Actividad S1 · 4 ejemplos · clasificá DAG → estrategia → método (15 min)
Formato: parejas · 2 min por caso (8 min) · 5 min plenario · 2 min síntesis.
| # | Caso | Pregunta causal | ¿Qué patrón? ¿Qué método? |
|---|---|---|---|
| A | 4G en Catatumbo | ¿La apertura de tramos 4G aumenta el empleo formal municipal? Datos panel anuales · distintos pueblos tratados en distintos años. | _____________ |
| B | Microcrédito BancaMía | ¿Recibir un microcrédito aumenta los ingresos del hogar? 2.000 hogares asignados aleatoriamente a recibir/no recibir · 1 momento. | _____________ |
| C | Cesárea automática | ¿La cesárea automática reduce mortalidad neonatal? Los hospitales aplican cesárea si peso al nacer < 2.500g · cross-section de 50.000 nacimientos. | _____________ |
| D | Reforma agraria Bolivia 2009 | ¿La reforma agraria boliviana redujo la concentración de tierras? Bolivia tratada · resto LATAM como controles · panel anual 1990-2024. | _____________ |
Respuesta en 1 línea: “Caso A: patrón [N°] · estrategia […] · método primario […] · cross-check […].”
🔧 Actividad S1 · cont. · respuestas
Respuestas + papers análogos (revelar al final · lecturas modernas para los 4 ejemplos):
- A · 4G Catatumbo → patrón 5 staggered → CS (Callaway & Sant’Anna, 2021) o CDH (de Chaisemartin & D’Haultfœuille, 2020). Análogo en literatura: (Asher & Novosad, 2020) AER · rural roads India con RDD + DiD.
- B · Microcrédito BancaMía → patrón 1 randomización → ITT/ATE. Base evidencial: (Banerjee et al., 2015) AEJ Applied · 6 RCTs cross-country.
- C · Cesárea automática → patrón 4 discontinuidad → RDD sharp (Cattaneo et al., 2020). Análogo: (Almond et al., 2010) QJE · umbral 1.500g.
- D · Reforma agraria Bolivia 2009 → patrón 5b 1-tratado → Synthetic Control (Abadie, 2021) o Synthetic DiD (Arkhangelsky et al., 2021).
🎓 JC 8/8 · Tu DAG H2 → tu estrategia → tu método (5 min)
Decisión personal · 7 pasos en papel · 5 min:
- Releé tu DAG H2 (S05, martes · U5).
- Identificá la arista D → Y principal.
- ¿De dónde viene la variación exógena de D? (las 4 fuentes del JC 1).
- Clasificá el patrón (1, 2, 3, 4, 5a/b/c, 6).
- Nombre la estrategia de identificación.
- Nombre el método primario.
- Nombre el método de cross-check (de la misma estrategia · ≠ primario).
Consejo
Output esperado (1 línea · al encabezado del PAP H3):
“Mi DAG H2 implica patrón [N°] (variación temporal staggered) · estrategia DiD moderna · método primario Callaway-Sant’Anna porque [datos · multiple-period · cohortes claras] · cross-check con de Chaisemartin-D’H porque [robustez a heterogeneidad].”
→ Esta frase entra al PAP H3 del domingo (dom 22/11 · 23:59) y es el input directo al Lab L4 (Sprint 2 · ahora).
Advertencia
Si tu decisión es “TWFE clásico” sin haber identificado el patrón ni nombrado un cross-check → la decisión está mal. Re-leé JC 6/8.
Lo que se llevan del Sprint 1: el método NO es un menú · es la respuesta operativa a tu DAG. Sprint 2 (Lab L4) es escribir el código que tu decisión de hoy implica · con IA auditada línea por línea.
☕ Break · 10 min · de la decisión al código
Café · estiramiento · verificá Copilot/Cursor activos · abrí el repo H2 · prepará tu DAG en pantalla — el Lab L4 arranca corriendo
Sprint 2 · 🤝 Lab L4 · Pair Programming Aumentado
15 JC · 45 Act · 60 min · IA escribe · vos auditás línea por línea
📍 Estructura del Sprint 2 · Lab L4 (60 min)
🎓 JC 1/4 · Reglas duras del Lab L4 · evidencia empírica (5 min)
El contrato del Lab L4 (no negociable):
- 🤖 La IA implementa · 👤 vos auditás. Si no podés explicar una línea en 30 seg → la rechazás · refactorizás · o te detenés.
- 📝 Audit log denso. Cada prompt + output + decisión queda en
audit/L4-pair-programming.md. Sin audit no hay entrega. - 🔍 ≥1 error introducido por IA debe ser detectado y documentado. Si no lo encontraste, no auditaste.
- 🔁 Cross-check obligatorio. ≥2 estimadores (CS · CDH · BJS). Convergencia gana confianza.
- 🔢 Semilla fija + sessionInfo + git commit por bloque. Reproducibilidad desde el byte 1.
Consejo
Evidencia empírica (no es teoría):
- Productividad +55.8% en tareas codificables (Peng et al., 2023) · RCT con 95 devs · GitHub Copilot.
- Jagged frontier (Dell’Acqua et al., 2023) · ganancia 0 o negativa en tareas fuera de la frontera de capacidad.
- Zona 🟢 augmentación (Bail, 2024) · pair coding está aquí · NO en 🔴 reemplazo.
Advertencia
5 errores típicos de la IA: paquete inventado · función con argumentos falsos · especificación que cambia en silencio · tipos mal convertidos · mediador usado como control. Documenta ≥1 en tu audit.
🎓 JC 2/4 · El prompt estructurado para pair programming (5 min)
Plantilla (en materiales/prompt-pair-programming.md):
# CONTEXTO
- Lenguaje: R (tidyverse + did + fixest)
- Datos: panel municipal · 2010-2022 · n=1100
- Tratamiento: post_4G (staggered · 2014-2022)
- Outcome: tasa_ocupacion (continua)
- DAG H2: Pavimento → Empleo (confounders: Z₁, Z₂)

# TAREA
Implementar event-study con Callaway-Sant'Anna:
1. Verificar tipos de columnas (id, time, treat)
2. Estimar ATT(g,t) con never-treated como control
3. Agregar a dynamic event-study
4. Plot con ggdid
5. Sin pre-treatment leads ≥ 4 periodos

# RESTRICCIONES
- No instalar paquetes nuevos sin confirmar
- Reportar warning() en consola si encuentra NA
- Comentar cada decisión metodológica

# ENTREGABLE
Script `code/01_did_cs.R` con
sessionInfo() y semilla 2026.
Consejo
Por qué este prompt funciona:
- CONTEXTO te ata al DAG H2 — la IA no inventa controles.
- TAREA es operativa · pasos numerados.
- RESTRICCIONES atan a la IA a tus reglas.
- ENTREGABLE define el output concreto.
→ Sin esta estructura, la IA improvisa · y improvisar es donde aparecen los 5 errores del slide anterior.
Advertencia
Trampa común: pegar el prompt y aceptar el output. No. Después del primer output, pedí:
“Antes de aceptar, explicame línea por línea qué hace y qué supuestos asume.”
Eso entra al audit log.
🎓 JC 4/4 · Picker de parejas + arranque (5 min)
Estructura del Lab L4 (45 min):
| Min | Actividad |
|---|---|
| 0–5 | En la sala de la pareja: compartir DAG H2 + decisión del Sprint 1 |
| 5–20 | Estimador primario (CS · CDH · SC · etc.) |
| 20–35 | Estimador secundario (cross-check) |
| 35–40 | Diagnósticos (Goodman-Bacon · pre-trends · placebos) |
| 40–45 | Cierre: commit · audit log · cross-check escrito |
Consejo
Rol del compañero/a de pareja:
- 👀 2do auditor — revisa tu audit log mientras vos codeás.
- 🧠 Devil’s advocate — pregunta “¿por qué aceptaste eso?” cada 10 min.
- 🤝 NO co-implementa — cada uno tiene su PAP/DAG/método.
→ Reglas idénticas al Lab L3, pero con código en lugar de DAG.
🔧 Lab L4 · 40 min implementación + 5 cierre
Stack sugerido R:
library(did)            # CS
library(DIDmultiplegt)  # CDH
library(fixest)         # SA via sunab()
library(bacondecomp)    # diagnóstico
library(HonestDiD)      # sensitivity
library(tidyverse)      # datos
library(modelsummary)   # tablas
En Python: differences (CS) · pyfixest · linearmodels.
Plantilla R abreviada (materiales/plantilla-DiD-eventstudy.R):
set.seed(2026)
panel <- read_csv("data/panel.csv")

# 1. Diagnóstico Goodman-Bacon
bd <- bacon(y ~ post_treat, panel,
            id_var="id", time_var="t")

# 2. CS · primario
att <- did::att_gt(yname="y", tname="t",
                   idname="id", gname="gtreat",
                   data=panel)
es  <- did::aggte(att, type="dynamic")

# 3. CDH · cross-check
cdh <- DIDmultiplegt::did_multiplegt(
  panel, "y", "id", "t", "post_treat",
  placebo=4, dynamic=4)

# 4. Comparar + plot
modelsummary(list(CS=es, CDH=cdh),
             output="output/tab_did.tex")
Advertencia
Reglas durante el Lab: 1) Audit log abierto y al día. 2) Cada error de IA va al audit con la etiqueta [ERROR_IA]. 3) Si la IA propone una especificación, tú decides. Eso no se delega.
🔧 Buffer de programación · 5 min · cerrá tu código
Sin café · sigan programando. Estos 5 min son para terminar el último chunk del Lab L4 y dejar 1 sola pantalla con: tu PAP draft · audit log al día · output principal a la vista. En 5 minutos 3 pares juzgan tu identificación — necesitan ver el código corriendo, no buscar archivos.
Sprint 3 · ⚔️ Adversarial Workshop + Replication Court
5 JC · 35 Act · 40 min · tus 3 compañeros juzgan tu identificación antes que el jurado real
📍 Estructura del Sprint 3 (40 min)
🎓 JC 2/2 · Protocolo del Replication Court (5 min)
Responde los ataques (2 min).
Acepta veredicto + 3 ataques.
Firma acta + plan de remediación.
Revisan código (audit log L4).
Proponen 3 ataques al supuesto principal.
Votan veredicto: ✅ defendible · ⚠️ con caveats · ❌ rechazado.
Cronometra fases.
Asegura que el autor escuche sin interrumpir en fase 2.
Entrega acta firmada al final.
4 fases por ronda (8 min cada una):
| Min | Fase | Quién habla |
|---|---|---|
| 0–2 | Presentación del PAP | 👤 Autor (DAG · método · supuesto principal) |
| 2–6 | Escrutinio + 3 ataques | ⚖️ Jueces (autor calla · secretario/a transcribe) |
| 6–7 | Respuesta del autor | 👤 Autor (acepta · refuta · marca para remediación) |
| 7–8 | Veredicto + acta firmada | ⚖️ Jueces votan · 📋 secretario/a entrega acta |
→ Cada estudiante juega autor 1 vez · juez 2 veces · secretario/a 1 vez (rotación).
🔧 Replication Court · 4 rondas · picker
Las 4 rondas (8 min cada una · somos 4):
| Ronda | Autor | Jueces | Secretario/a |
|---|---|---|---|
| 1 | Picker | los 2 siguientes | el cuarto |
| 2–4 | Rotación | Rotación | Rotación |
Cada ronda: 2 min el autor presenta su supuesto principal · 4 min ataques de los jueces · 2 min respuesta y veredicto.
→ Al final de la 4ta ronda, todos fueron autor una vez.
Consejo
Acta de cada ronda (plantilla): esencia del PAP · 3 ataques al supuesto principal · respuesta del autor · veredicto ✅ / ⚠️ / ❌ · plan de remediación para el H3 · firmas.
Advertencia
Reglas: el autor calla mientras lo atacan · se ataca el supuesto, no la persona · el acta va al audit log · el veredicto no afecta la nota; la remediación sí.
Sprint 4 · 🏁 H3 Lockdown · ASINCRÓNICO
Roadmap para el trabajo en casa · entrega dom 22/11 · 23:59
📍 Estructura del Sprint 4 · 🏁 H3 asincrónico
Advertencia
Este sprint NO se hace en aula. El lockdown vive en casa entre hoy a las 21:00 y dom 22/11 · 23:59. Ojo: el viernes (S07) y el sábado (S08) hay clase presencial. Lo que sigue es el roadmap que cierra la sesión de hoy.
make all (o equivalente) en otro computador y reproduce los outputs del PAP
🎓 Lo que entregás · checklist final (5 min)
Carpeta de entrega H3_apellido/:
H3_apellido/
├── README.md           ← orientación al revisor
├── PAP_moderado.md     ← documento principal
├── code/
│   ├── 01_diagnostico.R
│   ├── 02_did_primario.R
│   ├── 03_did_crosscheck.R
│   ├── 04_placebos.R
│   └── 05_sensitivity.R
├── output/
│   ├── tab_did.tex
│   ├── fig_eventstudy.pdf
│   └── fig_bacon.pdf
├── audit/
│   ├── L4-pair-programming.md
│   ├── replication-court-acta.md
│   └── AIAS-report.md
└── sessionInfo.txt
Consejo
Checklist H3 (PAP moderado + Lab L4 · 20%):
- ✅ PAP con 8 secciones canónicas Banerjee-Duflo
- ✅ Identificación justificada contra el DAG H2
- ✅ ≥2 estimadores modernos (no TWFE solo)
- ✅ Goodman-Bacon decomposition reportada
- ✅ ≥1 placebo + ≥1 sensitivity
- ✅ Pre-trends discutidos (Honest DiD si dudas)
- ✅ Audit log L4 con ≥15 entradas + ≥1 [ERROR_IA]
- ✅ Acta Replication Court con remediación
- ✅ Reporte AIAS modo 4 explícito
- ✅ Reproducible (
make allo equivalente)
🔧 Lockdown asincrónico · ~4h distribuidas hasta dom 22/11 · 23:59
Plan sugerido (distribuilo a tu ritmo · 4 sesiones de ~1h):
- (30 min · hoy, jueves noche) Relee el acta del Replication Court · marca los 1-2 ataques que vas a incorporar antes del submit.
- (60 min · viernes antes de S07) Edita el PAP: nueva sección de sensitivity · placebo nuevo · supuesto reformulado.
- (60 min · sábado después de S08) Re-ejecuta el script con la corrección. Verifica
make all(oRscript code/01..05.R). - (45 min · domingo AM) Audit log final: una entrada por cada cambio post-court. Reporte AIAS.
- (15 min · domingo PM) README del repo + commit + push antes de las 23:59.
Advertencia
Reglas duras del lockdown:
- 🔒 NO cambiás identificación radical en lockdown — el método ya se decidió.
- ✅ SÍ añadís sensitivity · placebos · clarificás supuestos.
- 📝 Cada cambio post-court entra al audit con etiqueta
[POST_COURT]. - 🤖 IA puede ayudar a redactar texto del PAP — sigue siendo modo 4 auditado.
- 🚫 NO dejás el audit log para el final · va en vivo.
Cierre
Lo que se llevan
Conceptual: - El método se elige por la pregunta · no por la moda. - TWFE clásico está roto con tratamiento escalonado (Goodman-Bacon, 2021). - CS · CDH · SA · BJS son canon moderno (Roth et al., 2023). - LLMs como datos = nuevo problema de medida (Ludwig et al., 2025). - PAP moderado = punto medio entre lock-in y post-hoc (Banerjee et al., 2020).
Operativo: - Goodman-Bacon decomposition obligatoria. - ≥2 estimadores como robustez · convergencia / divergencia documentada. - Lab L4 con audit log denso · ≥1 [ERROR_IA] detectado. - Replication Court · acta firmada · remediación trackeable.
Crítico: - p-hacking diferencial por método (Brodeur et al., 2020). - Pre-trends ≠ identificación (Roth et al., 2023). - LLMs introducen researcher degrees of freedom (Ludwig et al., 2025). - Reproducibilidad es estándar mínimo (Christensen & Miguel, 2018). - Jagged frontier: la IA se equivoca donde vos no la ves (Dell’Acqua et al., 2023).
Próximo (S07 · vie 20/11 · U7 · 4 h presencial): - 📊 Comunicación + ética IA² · hallazgos del Lab L5 (asincrónico, antes del viernes). - 🎲 Asignación de pares para el peer review. - 🎬 El sábado (S08) es el taller del video póster (H4, 35 %).
Pregunta de cierre
Si en S08 te preguntamos “¿qué hizo la IA por ti que tú no hiciste?” · ¿qué respondés sin que se vea como confesión de fraude — y sin que se vea como negación deshonesta?
Pre-trabajo para S07 y lecturas para el H3
Consejo
Para mañana (S07 · vie 20/11 · presencial · 38-303):
- Lab L5 asincrónico (90 min): audita tu propio hilo de prompts en
audit/L5-meta.md. - Podcast NotebookLM de U7.
- Ficha (Schwabish, 2021) (un gráfico dominante) y (International Committee of Medical Journal Editors, 2023) (autoría e IA).
Nota
Para el H3 (domingo):
- (Roth et al., 2023) · sec. 6 + tabla de software.
- (Banerjee et al., 2020) · In praise of moderation.
- (Brodeur et al., 2020) · sec. 5, transparencia.
Opcional: (Huntington-Klein, 2022) cap. 18 · (Cunningham, 2021) caps. 9 y 10.
Advertencia
🏁 ENTREGA H3 · dom 22/11 · 23:59 · 20% de la nota final.
Repo con la estructura del checklist · enlace en la carpeta de entrega de Interactiva · AIAS 4 declarado. S07 abre con 10 min de dudas del H3.
Conversar con el corpus de la unidad
💬 NotebookLM · Unidad 6
NotebookLM tiene cargadas todas las lecturas · slides · notas de esta unidad. Pregúntale conceptos · citas · conexiones · responde con referencia al material.
Requiere cuenta de Google. La conversación con el bot es parte del experimento: usar IA² para aprender IA².
Recordatorio · regla del aula
Si la IA escribió tu código y vos no lo auditaste línea por línea,
ese código no es tuyo · ese paper no es defendible · ese PhD no es real.
🎯 Modo AIAS 4 hoy = full support auditada. 🤖 La IA implementa · 👤 vos auditás · 📝 audit log denso · ⚖️ pares juzgan · 🏁 H3 sellado a las 23:59.
Apéndice · material de respaldo
Láminas de consulta. No se dictan en S06 (3 h online); sirven para el pre-trabajo y para escribir el PAP del H3.
🎓 JC 2/8 · Endogeneidad · cuándo OLS falla (5 min)
Definición técnica:
D es endógeno si
cov(D, ε) ≠ 0en el modeloY = β·D + ε.
Cuando esto pasa, β̂_OLS NO recupera el efecto causal — recupera una mezcla de causa + ruido confundido.
Las 4 fuentes clásicas de endogeneidad:
| # | Fuente | Mini-DAG |
|---|---|---|
| 1 | Variable omitida (OVB) Existe U no observado que causa D y Y simultáneamente. |
U → D, U → Y |
| 2 | Causalidad reversa Y también causa D · simultaneidad. |
D → Y, Y → D |
| 3 | Selección Quién recibe D no es aleatorio · self-selection o sample selection. |
U → S → muestra |
| 4 | Error de medida en D D se mide con ruido · attenuation bias. |
D ≠ D* observado |
Advertencia
El test mental de 30 segundos: mirá tu pregunta H1.
- ¿Hay algún factor no observable que afecte tanto D como Y? → endogeneidad tipo 1.
- ¿Podría Y afectar de vuelta a D? → endogeneidad tipo 2.
- ¿Quién recibe D se auto-selecciona o lo seleccionó el sistema? → endogeneidad tipo 3.
- ¿Tu medida de D captura el concepto teórico o es una proxy ruidosa? → endogeneidad tipo 4.
Si respondiste SÍ a alguna, OLS sin identificación está roto para tu pregunta.
Consejo
Por qué tu DAG H2 importa: U5 te enseñó a dibujar la endogeneidad. Cada arista no-bloqueada hacia D desde un confounder ES la endogeneidad. La estrategia de identificación (JC 3/8) es cómo se rompe esa arista.
🎓 JC 5/8 · DAG cuali y mixto · cuándo el patrón se sale del cuadro (5 min)
El DAG no es exclusivo de cuanti. Cuando tu pregunta es de mecanismo · proceso · casos · contexto, el DAG sigue siendo la herramienta — pero su función cambia.
Patrón A · Cualitativo · Process Tracing (Beach & Pedersen, 2019)
- N pequeño (típicamente 1-5 casos) · variación imposible o irrelevante.
- El DAG documenta la secuencia del mecanismo D → M₁ → M₂ → Y.
- Cada arista es una predicción observable que se valida con uno de 4 tests bayesianos: straw-in-the-wind · hoop · smoking gun · doubly decisive.
- “Identificación” no es exogeneidad — es eliminar explicaciones rivales del mecanismo.
→ Cuándo aplica: tu pregunta es “¿cómo opera el proceso?” · no “¿cuánto?”.
Patrón B · Mixto · Joint Display (Fetters, 2020) · (Creswell, 2014)
- El DAG es el marco unificador: cuanti identifica el ATT (D→Y) · cuali valida el mecanismo (D→M y M→Y) · juntos hacen inferencia robusta.
- 4 diseños canónicos: convergente paralelo · explicativo secuencial (cuanti→cuali) · exploratorio secuencial (cuali→cuanti) · embedded.
- Joint display: tabla 2 columnas que integra hallazgos cuanti + cuali con meta-inferencia explícita.
→ Cuándo aplica: - Cuanti dio efecto significativo · necesitás explicar por qué. - Cuanti dio null · necesitás explorar si fue ausencia o ruido. - Confounders no observables que cuanti no puede cerrar → cuali los identifica. - Heterogeneidad por contexto que ethnography revela.
Si tu hipótesis primaria (de U5) es mecanística, exploratoria o el patrón cuanti no aplica limpio → ver el recurso asincrónico Métodos mixtos modernos (~90 min). Cubre process tracing · QCA · LLM-aided coding · joint displays · 4 diseños Creswell-Plano Clark · checklist de auditoría · y la conexión explícita con el DAG H2. Lectura antes de S07 si tu tesis va por ese lado.
🎓 JC 7/8 · Los métodos como respuestas · cuadro síntesis (10 min)
| Patrón DAG | Estrategia | Método primario | Cross-check / robustez | Software |
|---|---|---|---|---|
| 1. Randomización | Comparar medias | OLS · ITT/ATE [@AtheyImbens2017Handbook] | Randomization inference · stratified balance [@BruhnMcKenzie2009] | fixest · ri2 |
| 2. Sel. observables | Condicionar en X | OLS + controles · CEM [@IacusKingPorro2012] · PSM [@Imbens2015Matching] | Oster δ [@Oster2019] · DR/DML [@Chernozhukov2018DML] | cem · MatchIt · robomit |
| 3. Instrumento | Explotar Z exógeno | 2SLS · LATE [@AngristImbensRubin1996] | Weak-IV F > 104.7 [@AndrewsStockSun2019] · Anderson-Rubin · MTE [@MogstadTorgovitskyWalters2024] | ivreg · ivmodel · ivmte |
| 4. Discontinuidad | Local randomization | RDD sharp/fuzzy local-linear [@CattaneoIdroboTitiunik2020] | Robust CI [@CalonicoCattaneoTitiunik2014] · McCrary moderno · placebos | rdrobust · rddensity |
| 5a. DiD 2×2 | DiD clásico | TWFE (sólo 1 grupo · 1 momento) | Event-study · placebos pre-trends | fixest |
| 5b. DiD staggered | DiD moderno | CS · CDH · SA · BJS | ≥2 estimadores en paralelo · Honest DiD (Rambachan-Roth) | did · DIDmultiplegt |
| 5c. 1 tratado | Counterfactual sintético | Synthetic Control · SDID | Placebo in-space · in-time · permutation | Synth · synthdid |
| 6. Alta dimensión | ML para nuisance | DML (Chernozhukov) · Causal Forest (Athey-Wager) | Múltiples seeds · sample splitting · validation | DoubleML · grf |
El insight central: el nombre del método NO es lo importante. Lo importante es la estrategia de identificación que tu DAG implica. Una vez que la estrategia está clara, los métodos son implementaciones intercambiables — por eso siempre corrés ≥2 como cross-check.
🎓 JC 3/4 · El audit log L4 · cómo se ve (5 min)
Estructura por entrada:
| # | Hora | Prompt enviado (resumen) | Output recibido (esencia) | Decisión | Justificación / acción |
|---|---|---|---|---|---|
| 01 | 09:42 | "Implementá CS event-study staggered con never-treated como control · panel.csv" | Sugiere did::att_gt(...,control_group="nevertreated") + agregación dinámica + plot |
✅ ACEPTAR | Verifico clase de id (factor), tipo de time (int), gname correcto. Corro · plot razonable. Commit. |
| 02 | 09:55 | "Añadí CDH con DIDmultiplegt para cross-check" | Sugiere did_multiplegt(...,placebo=4) pero omite argumento dynamic=4 |
⚠️ EDITAR | Sin dynamic, no comparable al event-study de CS. Lo añado manualmente. Documento. |
| 03 | 10:08 | "¿Cómo manejo unbalanced panel?" | Sugiere na.omit() en todo el panel |
❌ RECHAZAR | ERROR DETECTADO: drop indiscriminado introduce sesgo selección. Pedir versión con panel = "unbalanced". |
Advertencia
Mínimo de entradas para H3: ~15–25 prompts auditados. Calidad > cantidad — preferí 15 con justificación densa que 50 con “✅ ACEPTAR” sin comentario.
🛠️ Las 2 herramientas modernas de transparencia (bonus · 3 min)
Antes de que los jueces ataquen, podés blindar tu PAP con dos técnicas frontier 2020+:
📊 Specification Curve (Simonsohn et al., 2020)
Enumerá todas las especificaciones razonables (controles · clusters · medidas), corré las N, plotealas ordenadas. Si la mayoría es del mismo signo → robustez alta.
library(specr)
setup <- setup(data, y, x,
  controls = c("c1","c2","c3"),
  subsets = list(region = c("A","B")))
spec_curve <- specr(setup)
plot(spec_curve)
→ Output: curva + decomposicional de qué decisión mueve más.
🌌 Multiverse Analysis (Steegen et al., 2016)
Enumerá todas las decisiones razonables sobre el dataset (filtros · missing · outliers · codificación), generá la matriz de datasets, corré tu análisis en todos.
→ Output: histograma de p-values + curva de coeficientes a través de los N datasets.
Pareja perfecta con spec curve: multiverse maneja decisiones de datos; spec curve maneja decisiones de modelo.
Advertencia
Por qué importa hoy: (Munafò et al., 2017) · el manifesto canónico de open science 2017 — pre-registración + spec curve + multiverse + open data + replication = el stack 2026 de transparencia. Si tu PAP no incluye al menos 1 de estas técnicas modernas, el Replication Court te lo va a marcar.
🎓 JC 1/2 · Por qué Replication Court · Brodeur 2020 (5 min)
(Brodeur et al., 2020) · Methods matter — p-hacking and publication bias in causal analysis in economics:
Análisis de ~22.000 t-statistics de 25 revistas top muestra exceso sistemático de p-valores justo abajo de 0.05 — y el exceso depende del método:
- RCT: poco exceso (lock-in fuerte).
- RDD: poco exceso (visualización forzosa).
- DiD: alto exceso (specification flexibility).
- IV: muy alto exceso (instrument flexibility).
Advertencia
Implicación normativa:
El método que elegís predice el riesgo de p-hacking que vas a enfrentar.
→ Si tu método es DiD o IV, el escrutinio adversarial es especialmente importante. No porque vos seas tramposo, sino porque la flexibilidad de especificación es estructural.
→ El Replication Court es la versión pedagógica del peer review previa a la sustentación.
Consejo
Spirit of moderation: este sprint no busca destruir tu PAP — busca fortalecerlo contra ataques predecibles, antes de que aparezcan en U8.
Referencias
EC0744 · Seminario de Investigación Aplicada Universidad EAFIT · Escuela de Finanzas, Economía y Gobierno 2026-2