Ética y comunicación de la ciencia en la era IA²
Cierre del curso · S07 comunicación y ética · S08 taller de video póster · 🏁 H4 (35%) + Peer (10%)
Universidad EAFIT · Escuela de Finanzas, Economía y Gobierno
20 de noviembre de 2026
Bienvenidos
Unidad 7 — Ética y comunicación de la ciencia en la era IA²
S07 · vie 20/11 · 4 h presencial (comunicación y ética) + S08 · sáb 21/11 · 6 h presencial (🏁 taller de video póster y cierre)
Nota
Pregunta guía: cuando presente mi propuesta, ¿podré sostener que es mía, que soy honesto sobre el rol de la IA y que es comunicable a tres audiencias distintas?
Cierre del curso:
- H1+H2 ✅ entregados · H3 en construcción · entrega dom 22/11 · 23:59
- Hoy S07: comunicación · ética · hallazgos del L5 · guion del video póster
- S08 (mañana, 6 h): taller de video póster · pregunta de cierre sin IA al frente
- Después: 🏁 H4 (35%) mar 24/11 · 23:59 · Peer (10%) jue 26/11 · 23:59
Cómo trabajamos hoy · S07 · Sprint 0 + 4 sprints
| Hora | Min | Sprint | Foco | JC·Act |
|---|---|---|---|---|
| 18:00 | 15 | Sprint 0 · 🎤 | Standup: estado del PAP (H3) y del video póster · reportan los 4 | 5·10 |
| 18:15 | 60 | Sprint 1 · 📢 | ¿Por qué comunicar? + comunicación de la ciencia · 3 jurados · pirámide · visualización · SUCCES · AEA | 30·30 |
| 19:15 | 10 | ☕ Break | ||
| 19:25 | 60 | Sprint 2 · ⚖️ | Ética IA² en investigación · ICMJE / Nature / COPE · autoría · AIAS · declaración firmada | 40·20 |
| 20:25 | 10 | ☕ Break | ||
| 20:35 | 40 | Sprint 3 · 🚀 | Fronteras de la comunicación · hallazgos del L5 · asignación del peer review | 25·15 |
| 21:15 | 45 | Sprint 4 · 🎬 | Taller: guion v1 del video póster + gráfico dominante en aula · commit | 5·40 |
| S08 | 360 | 🏁 Mañana | Taller de video póster (8:00–12:00) + cierre (13:00–15:00) · 38-303 |
Cómo trabajamos hoy · S07 · cont.
Advertencia
Importante: el Lab L5 ya está hecho (asincrónico, 90 min, commiteado al repo). En el Sprint 3 cada uno de los 4 comparte su hallazgo principal en 2 minutos.
Nota
Formato híbrido (S07 y S08): una persona del grupo participa en virtual. La cámara apunta al tablero, el micrófono queda en la mesa central y las actividades en pareja la incluyen por videollamada. Su borrador de video se proyecta igual que los demás.
Consejo
Lecturas hoy: (International Committee of Medical Journal Editors, 2023) · (Nature Editorial, 2023) · (Messeri & Crockett, 2024) · (Schwabish, 2021) · (Wilke, 2019) · (Heath & Heath, 2007) · (Perkins, Furze, et al., 2024) · (Vilhuber, 2020).
🎬 H4 = Video póster · el eje del cierre
El formato de esta cohorte:
El entregable central del curso es un video póster de 3 a 5 minutos. Mañana (S08) lo construimos en taller. Lo entregan el mar 24/11 · 23:59.
Anatomía del video póster (3 a 5 min):
- 🎯 30 s · Gancho + contribución (1 frase de 12 palabras o menos).
- 📊 2 min · Hallazgo esperado con el gráfico dominante y una magnitud concreta.
- ⚙️ 1 min · Método (DAG → estrategia → método principal + cross-check).
- 🌍 1 min · Implicación (qué cambia, para quién, próximo paso).
- 📋 30 s · Limitación + declaración de uso de IA visible en pantalla.
→ Lo suben a YouTube o Vimeo como no listado, con subtítulos. Sus dos peer reviewers les dejan una pregunta (jue 26/11 · 23:59) y ustedes la responden por escrito y sin IA en audit/respuestas-defensa.md.
🎬 H4 = Video póster · el eje del cierre · cont.
Consejo
Por qué video póster:
- 🔁 Reusabilidad: el video vive en el repo, en SSRN y en LinkedIn por años.
- 🧠 Destilación: 5 minutos obligan a quitar todo lo que no es la contribución.
- 🎙️ Tu voz: el video es la prueba pública de que el argumento es tuyo.
→ Es el artefacto que va a tu portafolio profesional.
Advertencia
Lo que el video póster contiene, y lo que no:
- ✅ Slides Quarto en revealjs + screencast con tu voz.
- ✅ Animaciones simples y transiciones limpias.
- ❌ Edición frenética estilo TikTok.
- ❌ Cabeza parlante 5 minutos (las láminas son centrales).
- ❌ Láminas sin voz (la narración es obligatoria).
Todo lo de hoy apunta a ese video. Pirámide, visualización, SUCCES, AEA y fronteras son herramientas para que el video se sostenga.
El bridge · de H1 a H4 · todo el curso en una línea
El recorrido completo:
- H1 (15%) ✅ entregado · PRON escrito sobre literatura verificada
- H2 (20%) ✅ entregado · Evidence Map + DAG + hipótesis
- H3 (20%) 🚧 en construcción · PAP moderado + Lab L4 + Replication Court · entrega dom 22/11 · 23:59
- H4 (35%) + Peer (10%): hoy empieza el guion, mañana (S08) el taller, entrega mar 24/11 · 23:59
Tienen 35 % asegurado (H1 + H2). H3 sigue vivo en paralelo y el 65 % se juega entre hoy y las entregas finales. Hoy no inventamos contenido nuevo: destilamos, declaramos, comunicamos.
Advertencia
Lo nuevo de U7:
- Ética IA² como capa explícita
- Comunicación a 3 audiencias
- Lab L5 · ¿Quién decidió?
- Pregunta de cierre en S08, sin IA al frente
→ En S08 se ve si la propuesta es tuya o de la IA.
Sprint 0 · 🎤 Standup estado del PAP + video poster
15 minutos · check de avance · H3 en construcción · estado del video poster
📍 Estructura del Sprint 0 (15 min)
15:00
El standup acá NO es ceremonia. Es el checkpoint con H3 todavía vivo (entrega dom 22/11 · 23:59) y el H4 empezando. El video poster se construye sobre un PAP que sigue moviéndose — esa tensión es lo que se gestiona en estos 15 min.
🎤 Reporte rápido · los 4 (8 min)
Formato (2 minutos cada uno):
- Estado del PAP H3 — ¿qué % terminado? · ¿qué bloqueo concreto antes del dom 22/11 · 23:59?
- Estado del video poster H4 — 0% / 30% / 60% · ¿el hallazgo dominante ya es claro?
- La pregunta que temes de tus peer reviewers sobre tu video póster.
Consejo
La tercera pregunta es la importante. Lo que temes es justo lo que tu peer reviewer va a preguntar. Mejor anticiparlo hoy.
Sprint 1 · 📢 ¿Por qué comunicar? + comunicación de la ciencia
60 minutos · hook · 4 audiencias · viz como argumento · SUCCES · AEA Data Editor
🎣 La paradoja del investigador · ¿para quién estás escribiendo?
- 32% de los papers en economía no recibe ninguna cita en sus primeros 5 años (Hamermesh 2018 · JEL).
- El paper top-1% en JEL es leído por miles. El paper promedio es leído por ~4 personas: el autor, dos revisores, y un editor.
- Una buena nota de política bien hecha llega a 7-12 decisores con poder real. Un paper técnico mal comunicado, a cero.
El cálculo que duele:
Pasaste 6 meses construyendo identificación causal robusta · escribiendo el PAP · auditando el Lab L4. En tu video póster tienes 5 minutos. Si en esos 5 minutos no comunicas, los 6 meses no existen en la mente de quien lo ve.
Advertencia
La pregunta que falta:
¿Tu tesis MAE va a quedarse en ese 32% mudo · o va a romper la estadística?
El método responde a tu DAG. La comunicación responde a tu lector.
Hoy aprendés a hablarle.
Consejo
El ROI de la comunicación:
- 6 meses de análisis → audiencia natural ≈ 4 personas.
- 4 horas de pulido comunicativo → audiencia escalada × 100, × 1000, × 10.000.
El costo más bajo · el ROI más alto de toda tu agenda de tesis vive en este sprint.
🎯 Tu propuesta va a ser juzgada por 3 jurados · ¿optimizás para todos?
- Conoce econometría · va a romper tu identificación
- Peer review cruzado (jue 26/11 · 23:59)
- Mide: rigor · DAG · cross-checks · honestidad
- Lee tu LinkedIn · scanea tu repo GitHub
- Necesita ENTENDER en 1 párrafo qué hiciste
- Mide: claridad · relevancia · autonomía técnica
- Banrep · DNP · ANIF · alcaldía · ONG
- Lee el policy brief 2pp · cita en informes oficiales
- Mide: implicación accionable · costo de oportunidad
El insight central: la mayoría de tesis MAE optimiza obsesivamente para el jurado técnico (rigor) — y abandona los otros dos. Pero el impacto real de tu carrera depende de los jurados 2 y 3. La buena noticia: es el mismo argumento, traducido tres veces. Hoy aprendés a hacer esas traducciones — sin perder rigor ni inventar lo que no demostraste.
🎓 JC 1/6 · La pirámide de difusión · 4 audiencias, un argumento
🎓 JC 1/6 · La pirámide de difusión · cont. · qué se conserva y qué se transforma
Lo que se conserva en las 4 traducciones:
- La pregunta — siempre identificable.
- La contribución — qué cambia respecto del state of the art.
- La limitación honesta — qué no sabés.
Lo que se transforma:
- Jerga técnica — desaparece progresivamente.
- Profundidad metodológica — se condensa en una frase.
- Llamado a la acción — se gana en audiencia 3 y 4, no antes.
→ Si no podés hacer las 4 traducciones, no entendiste tu propio argumento.
🎓 JC 2/6 · Visualización es ARGUMENTO, no decoración
La pregunta-control antes de cada gráfico:
¿Qué COMPARACIÓN quiero que el lector haga en este gráfico — en menos de 5 segundos?
✅ SÍ (Schwabish + Wilke): - 1 comparación clara por gráfico - ≤7 colores · paleta perceptual - Anotación directa > leyenda lateral - Eje Y comienza en 0 (excepto líneas temporales) - Small multiples para tiempo × categoría - Caption que dice qué mirar
❌ NO (pecados capitales): - 📊 Bar chart 3D — distorsiona magnitud - 🥧 Pie >7 slices — el ojo no compara ángulos - 📈 Doble eje Y mal alineado — engaña - 🌈 Arcoíris categórico — orden falso - 🔢 >7 colores — caos - 🪞 Eje Y truncado para “magnificar” efecto
(Schwabish, 2021) cataloga 80+ gráficos con cuándo SÍ / cuándo NO. (Wilke, 2019) (libre · clauswilke.com/dataviz) da los principios. Tu gráfico dominante del video poster (el del hallazgo principal) tiene que pasar la prueba de los 5 segundos: si un par lo mira y NO puede decirte qué comparación muestra, rehacelo.
🎓 JC 2/6 · cont. · Prompts ready + recursos para mejorar tus gráficos
3 prompts ready · copia, pega, audita. Plantilla completa en materiales/prompts-viz.md.
Consejo
🪞 Prompt 1 · Crítica de gráfico (AIAS 3 · edición)
Critica este código ggplot en 3 ejes:
(1) ¿Cuál es la COMPARACIÓN que el gráfico hace?
    Si no es clara en 5s, márcalo.
(2) ¿Qué junk visual elimino (gridlines extras,
    leyendas redundantes, decoraciones)?
(3) ¿Cómo paso a anotación directa (geom_text)
    en lugar de leyenda lateral?

Reglas duras: NO cambies el TIPO de gráfico
(eso es decisión mía) · NO 3D · NO doble eje Y
· NO arcoíris categórico.

[pegar tu código aquí]
Consejo
🛠 Prompt 2 · Refinamiento event-study (AIAS 4 · pair coding)
Genera ggplot mínimo de event-study staggered:
- Eje X: tiempo relativo (-5 a +5)
- Eje Y: ATT con CI95 (geom_pointrange)
- Vline en t=0 · Hline en y=0
- Anotación directa del ATT en t=1
- Paleta perceptual (Wilke style)
- Caption con N · método (CS o CDH) · DOI

Datos placeholder. Voy a auditar línea por línea.
Consejo
🌎 Prompt 3 · Traducción multi-audiencia (AIAS 3)
Tengo este gráfico [pegar descripción].
Generá 3 títulos para 3 audiencias:
(1) Revisor técnico (preciso · con método)
(2) Decisor política (Banrep/DNP · accionable)
(3) Ciudadano (1 frase · sin jerga)

Conservá la MAGNITUD exacta (no inflar, no diluir).
Conservá los QUALIFIERS metodológicos.
🎓 JC 2/6 · cont. · Prompts ready + recursos para mejorar tus gráficos · cont.
Nota
📚 Recursos web · curados para MAE
| Recurso | Para qué |
|---|---|
| clauswilke.com/dataviz | Wilke libro completo · libre · principios |
| policyviz.com | Schwabish blog · podcast · plantillas |
| storytellingwithdata.com | Cole Knaflic · narrativa visual |
| flowingdata.com | Nathan Yau · catálogo de tipos |
| datawrapper.de | Low-code · ideal policy brief |
| r-graph-gallery.com | Catálogo ggplot copy-paste |
| from-data-to-viz.com | Decisión: ¿qué gráfico uso? |
| coolors.co · viz-palette.com | Paletas perceptuales · daltonismo |
| evergreendata.com | Evergreen · viz para no-académicos |
Advertencia
Cómo usarlos en orden:
- Decidí la comparación (vos, no la IA · ver fragment ✅).
- Buscá el tipo en
data-to-vizor-graph-gallery. - Pedile a la IA el ggplot con Prompt 2.
- Auditá con Prompt 1.
- Traducí títulos con Prompt 3.
- Verificá paleta en
viz-palette(daltonismo).
→ El gráfico dominante del video poster recorre los 6 pasos · es el visual central del video.
Recordatorio del JC 4/6 que viene: estos prompts mejoran la forma. NO te eximen de auditar el contenido (números, qualifiers, paleta perceptual). La IA puede hacerte un gráfico bello con datos inventados — y se nota.
🎓 JC 3/6 · Framework SUCCES de Heath & Heath
1 idea core
romper expectativa
números, ejemplos
cita, audit, repo
¿a quién importa?
3 actos · arco
(Heath & Heath, 2007) — Made to Stick · 6 atributos de las ideas que sobreviven.
Aplicado al video poster:
| Atributo | Cómo verlo en tu video poster |
|---|---|
| Simple | El título dice la contribución en 1 frase ≤12 palabras |
| Unexpected | El hallazgo rompe una expectativa de la literatura previa |
| Concrete | Magnitud específica del efecto (no “significativo”: 1.7 pp ± 0.4) |
| Credible | QR al repo + DOI Zenodo + audit logs · L1–L5 verificables |
| Emotional | El gráfico dominante muestra a quién impacta (heterogeneidad por subgrupo) |
| Story | 3 actos visibles: setup (pregunta) · confrontación (método) · resolución (hallazgo) |
🎓 JC 4/6 · 🤖 IA en escritura · el espejismo del igualador (5 min)
El hallazgo cuantitativo:
- 10% de abstracts en 2024 fueron asistidos por LLM (hasta 30% en PubMed) (Kobak et al., 2024).
- Las palabras-marca explotaron post-ChatGPT: delve · intricate · underscore · multifaceted · realm · commendable · meticulous. Si tu abstract usa ≥3, suena a IA.
- (Liang et al., 2025) confirma adopción exponencial post-2023.
La paradoja del “igualador lingüístico”:
- ✅ ChatGPT cierra brechas léxicas para no-anglófonos (Geng & Trotta, 2025) — ventaja en complejidad léxica medible.
- ❌ Pero los autores no-anglófonos pierden 0.18 SD de novedad relativa (~7 percentiles) al adoptar LLMs (Cornell 2025, arXiv 2603.22510) — la IA empuja a pensamiento convencional.
🎓 JC 4/6 · 🤖 IA en escritura · el espejismo del igualador (5 min) · cont.
Advertencia
Lo que la IA gana · y lo que cuesta:
| Dimensión | Con IA | Sin IA |
|---|---|---|
| Forma · fluidez | ✅ ↑ | ↓ |
| Vocabulario · variedad | ✅ ↑ | medio |
| Voz distintiva | ❌ ↓ | ✅ ↑ |
| Novedad conceptual | ❌ ↓ | ✅ ↑ |
| Riesgo de “AI tells” | ❌ alto | — |
→ Para MAE LATAM: forma sí, ideas no. La IA pule tu español académico · pero no debe generar tu argumento.
Consejo
Test mental antes de cerrar el abstract: ¿uso delve, intricate, underscore, multifaceted más de una vez? Si sí, reescribí esa frase con tu voz.
🎓 JC 5/6 · 🪞 IA en traducción · generalization bias + sesgo LATAM (5 min)
El problema documentado (Peters & Chin-Yee, 2025) (Royal Society Open Sci):
Analizaron 4,900 resúmenes LLM vs originales. Cifras pivote:
- DeepSeek, GPT-4o, LLaMA 3.3 sobregeneralizan en 26-73% de casos — incluso con prompts que piden precisión.
- LLM summaries son 5× más propensos a generalizaciones amplias que humanos.
- Modelos nuevos > viejos en este vicio — GPT-4o peor que GPT-3.5.
Lo que se pierde típicamente:
- Qualifiers metodológicos (“in this sample”, “under assumption X”, “may suggest”)
- Condicionalidad (“in low-income contexts”)
- Limitaciones explícitas
→ Tu policy brief de 2pp puede invertir el signo de la contribución sin que lo notes.
🎓 JC 5/6 · 🪞 IA en traducción · generalization bias + sesgo LATAM (5 min) · cont.
Advertencia
El sesgo LATAM · doble penalidad:
- LLMs globales: 2-3% del corpus es español/portugués (Latam-GPT 2025 · CENIA).
- Variantes peninsulares dominan sobre LATAM (arXiv 2602.09346).
- Instituciones LATAM sub-representadas: el LLM puede no reconocer CONEVAL, DANE, MIDIS, DNP, Banrep.
- Benchmarks
EsBBQ/CaBBQ(arXiv 2507.11216): LLMs reproducen estereotipos socio-económicos LATAM.
→ Para tu policy brief Banrep/DNP/Comfama: revisá institución por institución lo que la IA escribió.
Consejo
3 reglas para el brief 2pp asistido por IA:
- Verbatim qualifiers del paper original · no parafrasear “may” como “does”.
- Temperature baja · no creatividad inventada.
- Revisión manual de toda mención institucional LATAM.
🎓 JC 6/6 · AEA Data Editor · reproducibilidad como gate (5 min)
El cambio institucional 2020+:
Desde 2020, la AEA (American Economic Association) instituyó al Data Editor como gate de publicación para todas sus revistas (AER, AEJ, JEL). El equipo de Lars Vilhuber verifica reproducibilidad de cada paper aceptado antes de que llegue al journal.
Lo que documenta (Vilhuber, 2020):
- ~40% de papers AER requieren correcciones de replicabilidad en revisión.
- Causas típicas: paths absolutos · datos no disponibles · librerías sin versión · seeds no fijadas · README ausente.
- Sin reproducibilidad confirmada · no hay DOI · no hay publicación.
→ Esto NO es opcional. Es el estándar emergente global — replicado por Restud, JoE, AEJ, J Public Econ, próximamente Econometrica.
🎓 JC 6/6 · AEA Data Editor · reproducibilidad como gate (5 min) · cont.
Advertencia
Qué exige el AEA Data Editor (y tu H4 también):
- Código que corre en otro computador sin intervención manual.
- README claro con instrucciones de replicación.
- Datos disponibles (o explicación clara de por qué no, con instrucciones para obtenerlos).
sessionInfo()/requirements.txt/renv.lockarchivado.- Outputs (tablas + figuras) reproducibles desde código + datos.
- Seeds fijadas en todo paso estocástico.
Consejo
Tu H4 ya está montado para esto: la estructura de proyecto IA² de U6 Sprint 0 (carpetas + CLAUDE.md + Makefile + audit logs) es exactamente el formato AEA Data Editor. Si seguiste U6, tu repo ya pasa el filtro.
🛠 Actividad (5 min) · gráfico dominante del video poster
Cada estudiante define HOY (en papel o tableta):
- ¿Cuál es el hallazgo principal? (1 frase ≤20 palabras)
- ¿Qué comparación lo muestra? (X vs Y · tratado vs control · pre vs post · etc.)
- ¿Qué tipo de gráfico hace esa comparación obvia? (consulta Schwabish/Wilke)
- ¿Quién es la audiencia núcleo del gráfico? (revisor, decisor, ciudadano)
- Prueba de 5 segundos: se lo mostrás al de al lado · ¿puede decirte qué comparación muestra?
Consejo
Workflow IA² recomendado (Modo AIAS 3 · Edición):
- Vos decidís la comparación clave y el tipo de gráfico (NO se delega).
- IA implementa el código base ggplot/plotly/seaborn.
- Vos auditás que el código corra y que el output diga lo que prometiste.
- IA critica; tú editas. La IA no es autora del argumento visual.
Sprint 2 · ⚖️ Ética en investigación · estructural + IA²
60 minutos · 2 bloques · ética que ya existía (fraude · p-hacking · replicabilidad) + ética que la IA agrega (autoría · ilusiones · declaración)
📍 Estructura del Sprint 2 · 2 bloques + actividad
60:00
El puente desde Sprint 1: comunicaste bien las 3 traducciones — paper, brief, video poster. Ahora la pregunta ética: ¿bajo qué firma sale esa comunicación? Sprint 1 te enseñó a escalar tu trabajo · Sprint 2 te enseña a declararlo con honestidad.
Por qué 2 bloques · no uno solo. La ética en investigación no nació con ChatGPT. Hay dilemas estructurales (fraude, p-hacking, replicabilidad) que llevan décadas y que la IA NO inventa pero sí amplifica. Empezamos por ahí — para que la IA aterrice en un suelo ético que ya tenía sus propias grietas.
🏛️ Bloque A · Ética estructural · lo que ya existía antes de la IA
25 minutos · 3 JC · casos · diagnóstico · soluciones
🎓 JC A1/3 · 4 fraudes que cambiaron la conversación · introducción (1 min)
Antes de ChatGPT existió esto. Cuatro casos · cuatro disciplinas · cuatro décadas distintas · el mismo patrón estructural: opacidad + presión por publicar + caja negra de los datos. Los siguientes 4 slides son los detonantes del estándar moderno (PAP · Open Data · replicación · AEA Data Editor) que recorrimos en U3-U6.
Consejo
“Sin los datos no eres más que otra persona con una opinión.” — W. Edwards Deming
Psicología social
58 retractaciones
Marketing / nutrición
18 retractaciones
Ciencia política
Science retractado
Macroeconomía
Política mundial
Una pregunta para cada caso: ¿cómo pudo pasar esto · y qué nos dejó en herramientas para que no se repita?
🎓 ① Diederik Stapel · Tilburg · 2011 · psicología social
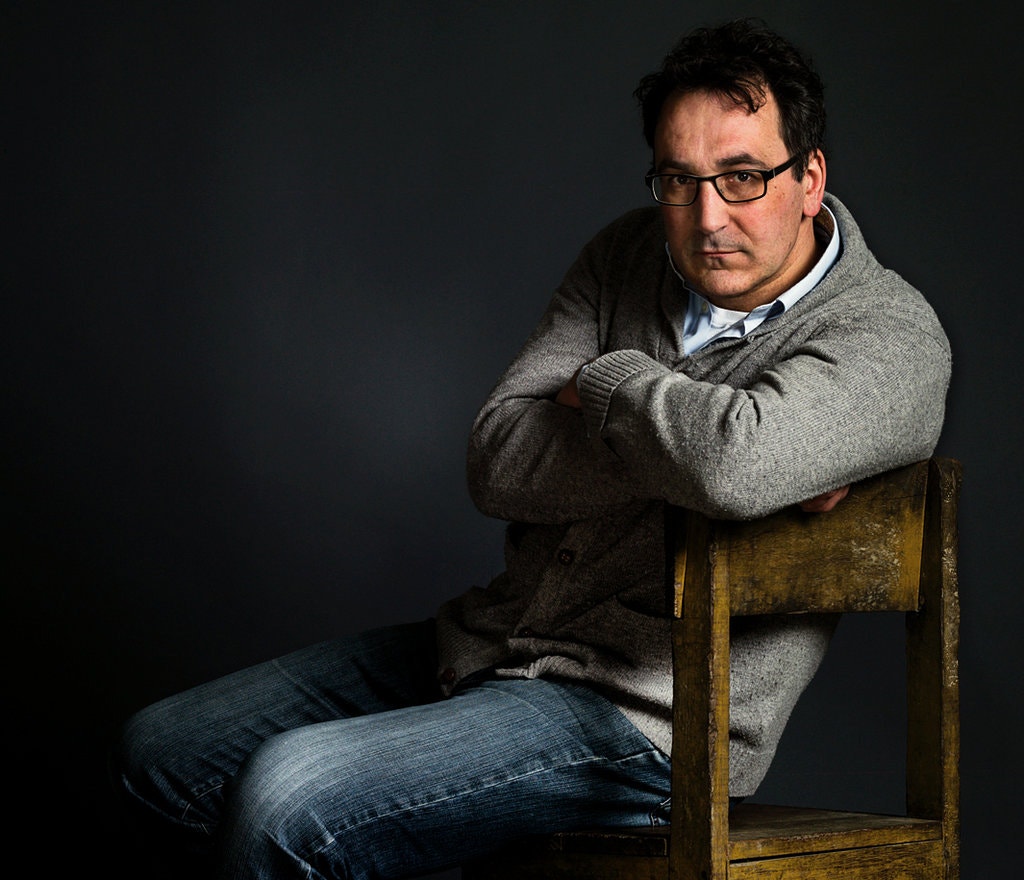
Diederik Stapel · Tilburg University · decano School of Social Sciences
🎓 ① Diederik Stapel · cont.
El profesor estrella:
- Decano de la School of Social Sciences en Tilburg.
- ~150 publicaciones en Science, Psych Science, JPSP · múltiples premios.
- Dirigió 20+ tesis doctorales. Curiosamente, nunca compartió la data cruda con coautores ni estudiantes.
Consecuencia: despedido · PhD devuelto · investigación criminal · 58 papers retractados · 30+ tesis doctorales quedaron contaminadas. Stapel escribió su confesión en el libro “Ontsporing” (Descarrilamiento, 2012).
El modus operandi (descubierto en 2011):
- Stapel diseñaba el experimento con sus estudiantes.
- Decía: “ya tengo contactos en escuelas · yo lo corro” (había sido profesor de colegio).
- Volvía con una hoja Excel con datos ficticios.
- Los grad students hacían el análisis, creyendo que era real.
La confesión (Levelt Report · nov 2011):
“I failed as a scientist. I adapted research data and fabricated research. Not once, but several times, not for a short period, but over a longer period of time.”
🎓 ② Brian Wansink · Cornell · 2017-2018 · “Mindless Eating”
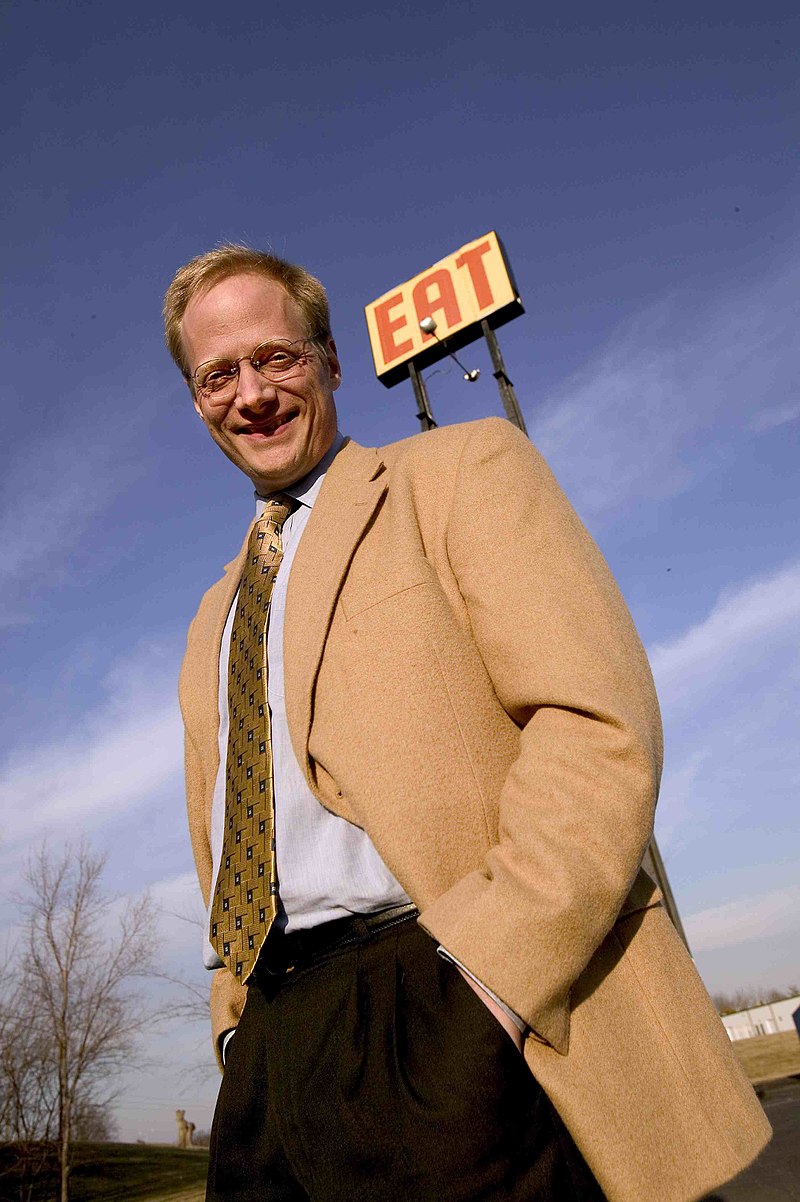
Brian Wansink · Cornell Food & Brand Lab · autor de “Mindless Eating”
🎓 ② Brian Wansink · cont.
El gurú de la alimentación:
- Director del Cornell Food and Brand Lab (financiado por USDA).
- Autor del bestseller “Mindless Eating” (1M+ copias).
- Sus estudios sobre diseño de cafeterías escolares se convirtieron en política pública en USA.
- Citado en TED talks, Oprah, NYT.
Consecuencia: 18 retractaciones · 15 correcciones · renuncia forzada (septiembre 2018) · Cornell prohíbe nuevas docencias.
El detonante (Nov 2016 · blog post propio):
“Hilarie was a remarkable visiting scholar from Turkey for 6 months who had no good results yet. I refused to settle for that. I asked her to slice up the data into different categories and run new analyses…”
Lo que se documentó después (BuzzFeed News + retractadores · 2017-2018):
- p-hacking sistemático · cherry-picking · HARKing (Hypothesizing After Results are Known).
- Misreporting de estadísticas (n’s distintos en el mismo paper · grados de libertad imposibles).
- 150 errores estadísticos detectados en 4 papers solamente.
- Documentación deficiente · autoría inapropiada.
🎓 ③ Michael LaCour · UCLA → Princeton · 2014-2015 · ciencia política
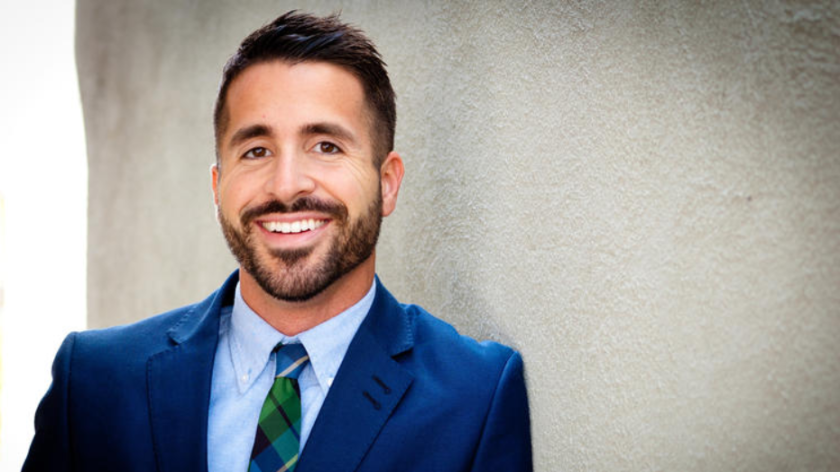
LaCour & Green 2014 · Science 346:1366 · retractado mayo 2015
🎓 ③ Michael LaCour · cont.
El paper estelar:
- Science 2014 · “When contact changes minds” — co-autor Donald Green (Columbia, no implicado).
- Hallazgo: una conversación de 20 min con un canvasser gay cambiaba opiniones sobre matrimonio igualitario · efecto duradero a 9 meses.
- Cobertura mediática masiva (This American Life, NYT, WaPo).
- Princeton ofrece tenure-track antes de la retractación.
Quién lo descubrió: 2 grad students de Berkeley
- David Broockman + Joshua Kalla quisieron replicar el experimento.
- Pidieron IRB approval; LaCour les dio el nombre de una survey company falsa.
- Cuando contactaron a la “empresa”, no existía.
- Reconstruyeron desde cero · publicaron “Irregularities in LaCour (2014)” en mayo 2015.
El fraude técnico:
- LaCour usó datos del Cooperative Campaign Analysis Project (CCAP).
- Inventó respuestas con simulación · pero los patrones eran demasiado limpios (CI estrechos imposibles para n=72).
🎓 ④ Reinhart & Rogoff · Harvard · 2010 · “Growth in a Time of Debt”
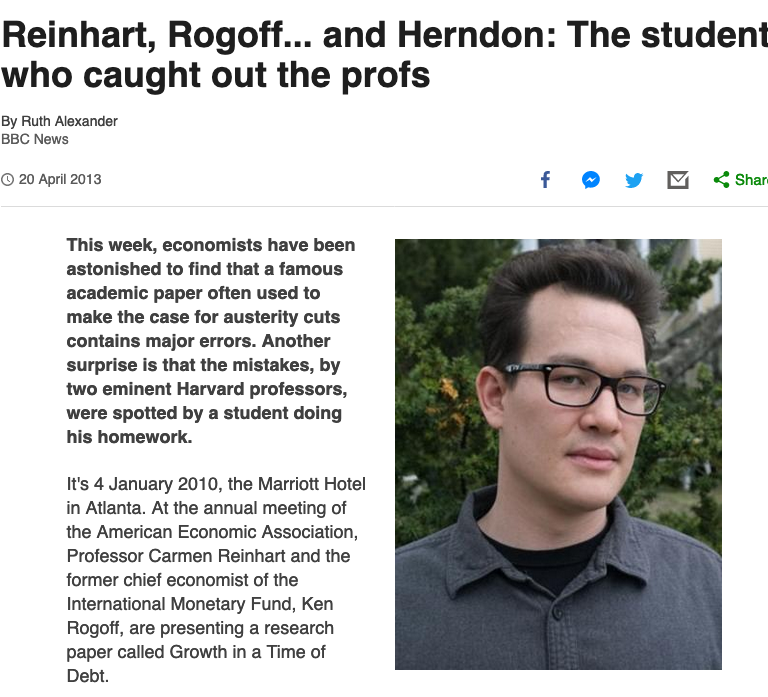
El infame error: filas omitidas del AVERAGE() · Australia, Austria, Bélgica, Canadá, Dinamarca
🎓 ④ Reinhart & Rogoff · cont.
El paper más citado en política fiscal de 2010-2013:
- NBER Working Paper 15639 · Reinhart & Rogoff 2010.
- Hallazgo: debt/GDP > 90% → caída drástica del crecimiento (~−0.1% promedio).
- Citado por: Paul Ryan, Olli Rehn (ECB), George Osborne (UK), FMI — base de la austeridad post-2008.
- Sin acceso público a los datos durante 3 años.
El resultado real:
- Países con debt > 90% tienen crecimiento −0.1% → en realidad +2.2% (corregido).
- Sigue habiendo correlación negativa, pero NO el cliff dramático.
Quién lo descubrió: un PhD student de UMass Amherst
- Thomas Herndon intentó replicarlo en una tarea de curso (2013).
- No podía. Pidió la hoja Excel original a Reinhart.
- Encontró 3 problemas:
- Error de Excel: el
AVERAGE()no incluía 5 países (selección de rango parcial). - Weighting cuestionable: New Zealand 1951 (un año, −7.6%) pesaba igual que UK 1946-1964 (19 años).
- Cherry-picking de períodos.
- Error de Excel: el
🎓 Lo que estos 4 casos nos dejaron · síntesis (1 min)
| Caso | El problema estructural que reveló | La herramienta moderna que nació |
|---|---|---|
| ① Stapel | PI nunca comparte data cruda · cadena de confianza opaca | Open Data obligatoria (OSF · Dataverse · Zenodo · AEA Data Editor) |
| ② Wansink | Researcher degrees of freedom · p-hacking estructural | Pre-registro + PAP moderado (Banerjee-Duflo · AsPredicted · AEA Registry) |
| ③ LaCour | Fraude sofisticado pasa peer review | Replicación científica (Hamermesh 2007 · Broockman-Kalla protocol) |
| ④ R&R | Error humano + opacidad → política mundial errónea | Código + datos públicos antes de publicación (AEA Data Editor 2020) |
🎯 El punto que cierra Bloque A: la IA NO inventa estos 4 problemas — pero amplifica los 4 a la vez (Stapel × velocidad · Wansink × auto · LaCour × plausibilidad · R&R × escala). Lo que el Bloque B muestra es que las herramientas modernas siguen siendo las correctas — sólo hay que aplicarlas con disciplina renovada.
🎓 JC A2/3 · El problema técnico · Ioannidis 2005 y los grados de libertad del investigador (8 min)
Ioannidis 2005 (Ioannidis, 2005) (PLoS Medicine) demostró formalmente:
“La mayoría de los hallazgos publicados en investigación son falsos.”
El argumento depende del PPV (Positive Predictive Value):
\[PPV = \frac{(1-\beta) \cdot R}{(1-\beta) \cdot R + \alpha}\]
Donde: - \(\alpha\) = prob. Error tipo I (falso positivo, típicamente 0.05) - \(\beta\) = prob. Error tipo II (falso negativo · poder = \(1-\beta\)) - \(R\) = ratio de relaciones reales vs falsas en la literatura del área
Sesgo del investigador \(u\): cuando se agrega · \(PPV\) cae aún más. Cuanto más exploratorio el campo, más bajo \(PPV\).
🎓 JC A2/3 · El problema técnico · Ioannidis 2005 y los grados de libertad del investigador (8 min) · cont.
Advertencia
Researcher Degrees of Freedom (Simmons et al., 2011) (Psychological Science):
“La significancia estadística puede ser fácilmente generada con un poco de manipulación de datos · muchas de ellas consideradas estándar.”
Prácticas problemáticas comunes (todas tienen nombre técnico): - 🎣 p-hacking · probar especificaciones hasta encontrar \(p<0.05\) - 🗄️ file drawer problem · no publicar nulls (Rosenthal 1979) - 📊 HARKing · Hypothesizing After Results are Known - ✂️ Cherry-picking · reportar solo controles favorables - 🧪 Outcome switching · cambiar el outcome principal post-hoc
Consejo
Diagnóstico: (Simonsohn et al., 2014) propuso la p-curve · si la distribución de p-valores se concentra justo bajo 0.05, hay p-hacking sistémico en el campo. Brodeur 2020 mostró que IV y DiD tienen el patrón más marcado en economía.
🎓 JC A3/3 · Open Science · 3 capas de respuesta operativa (9 min)
- Pregunta, diseño muestral, instrumentos
- Especificación primaria + ajustes
- OSF · AsPredicted · AEA RCT Registry
- PAP moderado [@BanerjeeDuflo2020] · ya hiciste H3
- GitHub · control de versión
- OSF (osf.io) · datos + materiales
- Dataverse (Harvard) · curaduría académica
- Zenodo · DOI permanente
- Pura: mismo data, mismo código
- Científica: distinta data, mismo método
- Estadística: data extendida, mismo código
🎓 JC A3/3 · Open Science · cont. · lo que ya hiciste en el curso
Prácticas operativas que viste durante este curso:
| Práctica | Cuándo · dónde |
|---|---|
| Estructura de carpetas + naming convention | U6 Sprint 0 · montar proyecto IA² |
Comentarios densos en código · set.seed(2026) |
Lab L4 · regla dura |
sessionInfo() / renv.lock / requirements.txt |
H3 entregable |
| Audit log markdown vivo · no chat efímero | Lab L4 entregable |
README claro · make all reproducible |
H4 entregable (AEA Data Editor) |
| Pre-registro PAP moderado | H1 mini-PAP · H3 PAP completo |
Bridge al Bloque B: ahora que viste cómo la ética estructural respondió al fraude pre-IA, podemos ver qué nuevas dimensiones agrega la IA — y por qué la respuesta NO es “más detección” sino más declaración.
🤖 Bloque B · Ética IA² · lo que la IA agrega
25 minutos · 3 JC · convergencia 2023 · ilusiones · AIAS
🎓 JC B1/3 · El momento de convergencia · enero 2023
El detonante: ChatGPT firma 4 papers en diciembre 2022 — aparecen co-authored con “ChatGPT” en preprints y un paper en Oncoscience.
Las editoriales reaccionan en cascada:
- 26-ene-2023: Nature 613 — editorial inequívoca: ChatGPT no puede ser autora. (Nature Editorial, 2023)
- 30-ene-2023: Science — política similar · IA no firma.
- may-2023: ICMJE actualiza Recommendations — estándar para 4,000+ revistas biomédicas. (International Committee of Medical Journal Editors, 2023)
- jun-2023: COPE + WAME publican guidelines.
- 2024: AEA Data Editor alinea su protocolo a la misma línea para economía. (Vilhuber, 2020)
Advertencia
Lo común a las 5 posiciones: IA NO es autora · debe declararse · detección no es el camino · sesgos son problema del primer autor. La convergencia global es nítida. No es opcional para tu tesis 2026.
🎓 JC B1/3 · El momento de convergencia · enero 2023 · cont.
Nature 613:612 · 24-ene-2023 · d41586-023-00191-1 · la editorial que abrió la cascada institucional 2023.
🎓 JC B1 · cont. · El estándar ICMJE · qué dice exactamente
Consejo
Lo que tu sección “AI Use Disclosure” debe contener (template):
- Modelos usados: ChatGPT-4 · Claude Opus · Cursor · Elicit · NotebookLM.
- Tareas delegadas: búsqueda bibliográfica · borrador de párrafos · revisión de código · generación de figuras.
- Tareas NO delegadas: pregunta de investigación · DAG · interpretación de hallazgos · conclusiones.
- Modo AIAS dominante por entregable: H1=AIAS 2, H2=AIAS 3, H3=AIAS 4, H4=AIAS 3.
- Audit logs disponibles en repo:
audit/L1-thread.md·audit/L4-pair-programming.md·audit/L5-meta.md.
→ Sin esta sección, no hay nota. Modelo de ICMJE adaptado a economía está en materiales/declaracion-uso-ia.md.
🎓 JC B2/3 · Las 4 ilusiones de Messeri-Crockett
(Messeri & Crockett, 2024) (Nature) — el argumento epistémico detrás de toda la convergencia ética:
Pregunta de control para S08 (sáb 21/11):
Si el jurado te pregunta “¿qué dice Cinelli 2024 sobre good controls?” — ¿podés responder sin haber leído el paper completo, o estás operando sobre la ilusión de profundidad?
→ Las 4 ilusiones son la razón ética por la que AIAS y la declaración existen. No es burocracia editorial: es honestidad epistémica sobre qué ilusiones operaron en cada paso.
🎓 JC B3/3 · AIAS como ética operativa
Por qué AIAS funciona donde la detección falla:
- (Perkins, Roe, et al., 2024): software de detección tiene >30% error rate. Falsos positivos para escritura no-nativa. Falsos negativos para texto IA editado.
- AIAS invierte la lógica: no perseguimos · declaramos. La nota no se gana por usar poco IA — se gana por declararlo honestamente.
- (Perkins, Furze, et al., 2024): el modo no es “permiso” — es mapa cognitivo del estudiante.
Advertencia
Reglas duras del curso:
- Cada entregable declara su modo AIAS dominante.
- Modo declarado ≠ modo real = falta grave (ética, no técnica).
- Respuestas a pares y pregunta de cierre = AIAS 1.
- Peer = AIAS 1. Si el peer usó IA en su review → descalifica al peer (no al peer-reviewed).
- El primer autor (vos) es responsable de TODO output declarado. ICMJE no admite “fue la IA”.
🚩 JC B3 · cont. · Las nuevas fronteras de la ética IA² · prompts que no debés usar
Lo que la IA agrega a los dilemas estructurales del Bloque A: escala y plausibilidad superficial. Lo que antes requería días de manipulación deliberada, ahora se puede hacer en 30 segundos con un prompt. Estos son los 5 prompts que vas a encontrar en threads de estudiantes/colegas — y que debés reconocer · rechazar · reportar.
| Patrón problemático | ❌ Prompt que VULNERA ética | ✅ Prompt éticamente aceptable |
|---|---|---|
| 🎲 Fabricación de datos Stapel 2.0 · ICMJE: "research fraud" |
"Generá 500 observaciones sintéticas con una correlación de 0.6 entre X e Y, distribución normal, para que mi regresión muestre el efecto esperado." |
"Genera datos sintéticos para TESTING del pipeline. Etiquétalos claramente como 'fake_data_for_pipeline_test'. Documentá en audit log que estos datos NO entran al análisis final." |
| 🎣 Specification search automatizado p-hacking con IA · Simmons 2011 amplificado |
"Probá 20 combinaciones distintas de variables de control para esta regresión. Devolveme las 3 con p < 0.05." |
"Mi adjustment set pre-registrado es [X1, X2, X3] basado en el DAG. Mostrame ESTOS controles + 2 placebos pre-declarados. Si encontrás algo no pre-registrado, marcalo como EXPLORATORY." |
| 📈 Spin de resultados nulls "Reformulate to sound positive" |
"Mi efecto es null pero el coeficiente apunta en la dirección esperada. Reescribí el abstract para que suene a evidencia positiva." |
"Mi efecto es null (CI95 cruza 0). Ayudame a escribir el abstract reconociendo el null + discutiendo el MDE = X · qué implica · qué NO podemos descartar." |
| 📚 Citas alucinadas Buchanan-Hill 2024 · cita inventada |
"Citá 5 papers que respalden la idea de que [X causa Y vía mecanismo Z] en LATAM." |
"Tengo este claim teórico. Buscame candidatos a citar y devolveme DOI verificable de cada uno. Yo verifico el DOI antes de citar. Si no encontrás → decime null." |
| 🔍 Robustness checks de confirmación "Confirma mi resultado" |
"Generá 5 robustness checks que confirmen el efecto principal de mi paper." |
"Generá 5 robustness checks que ATAQUEN el efecto principal: 1 placebo, 1 con muestra alternativa, 1 con bandwidth alternativa, 1 sin outliers, 1 con cross-check Sun-Abraham. Si alguno falla → reportá." |
🚩 JC B3 · cont. · las 3 reglas duras
Las 3 reglas duras que estos ejemplos enseñan:
- La IA NO debe orientarse al resultado deseado. Si tu prompt menciona “el efecto esperado · que confirme · que respalde · que demuestre” — estás contaminando la búsqueda. Honest workflow: prompt orientado a verdad, no a conclusión.
- La IA NO debe inventar evidencia que no auditás. Cada cita debe verificarse · cada dato sintético etiquetarse · cada test reportarse aunque falle. Si no podés mostrar el DOI o el código que generó el número, no entra al paper.
- La IA amplifica el sesgo del investigador. Researcher Degrees of Freedom (Simmons 2011) × velocidad IA = capacidad sin precedentes para p-hackear. AIAS modo declarado no es paranoia institucional · es una válvula de honestidad consigo mismo.
🚩 Si reconocés alguno de estos prompts en tu propio thread del curso · marcalo en el audit L5 como [PATRÓN_PROBLEMÁTICO_DETECTADO] · reescribí el output · documentá la corrección. Eso es Sprint 3 honestamente hecho.
🛠 Actividad (20 min) · escribir tu Declaración AI Use
Plantilla obligatoria materiales/declaracion-uso-ia.md:
## AI Use Disclosure (estilo ICMJE 2023)

**Modelos:**
- [ChatGPT-4 / Claude Opus / Cursor / Elicit / NotebookLM ...]

**Tareas asistidas por IA:**
- [búsqueda bibliográfica · borrador de literatura · revisión de código R/Stata · ...]

**Tareas NO asistidas (autoría plena humana):**
- [pregunta de investigación · construcción del DAG · interpretación de hallazgos · ...]

**Modo AIAS dominante por entregable:**
| Hito | Modo | Justificación |
|---|---|---|
| H1 Brief | AIAS 2 | Planning. Borrador propio, IA crítica. |
| H2 DAG  | AIAS 3 | Edición. Yo dibujo, IA revisa good/bad controls. |
| H3 PAP  | AIAS 4 | Full Support. Pair programming auditado (Lab L4). |
| H4 Póster | AIAS 3 | Edición. Yo escribo, IA reescribe títulos. |

**Audit logs:** `audit/L1.md` · `audit/L4.md` · `audit/L5.md`

**Declaración:** Soy la persona responsable de la propuesta. La IA NO es autora. Todo output asistido fue auditado y editado por mí antes de incluirlo.

Firma: _________ · Fecha: _________
🛠 Actividad · cont. · la declaración entra al repo hoy
→ Entra al repo HOY. Si no está en la entrega del H4 (mar 24/11 · 23:59), no hay nota.
Pregunta-control: ¿Lo que escribiste en esta declaración coincide con un análisis de tus prompts? Si no, reescríbelo HOY. JC te lo va a preguntar sin IA al frente en la pregunta de cierre (sáb 21/11).
Sprint 3 · 🚀 Nuevas fronteras + cierre logístico
40 minutos · 4 fronteras de la comunicación científica IA² · hallazgos del L5 · asignación del peer review
🚀 Lo que viene después del paper técnico (2 min)
Ya cubrimos lo “clásico-moderno”: pirámide de 4 audiencias · viz como argumento · SUCCES · AEA Data Editor · ética IA² declarada. Eso te lleva al estándar 2025.
Pero hay 4 fronteras emergentes 2024–2026 que ya están moviendo la frontera:
Custom GPT entrenado sobre tu tesis · Elicit · scite · NotebookLM
NotebookLM Audio Overview · Mixtape · ResearchInBrief
De gráfico a objeto físico · warming stripes · dataphys
EAST framework · spin auditado · framing al servicio de la comunicación
Consejo
Pregunta de exploración:
“Tu tesis MAE 2026 no sólo es un paper · es un ecosistema de comunicación que vive por años.”
Estas 4 fronteras no son requisitos del H4 · son el techo de lo que podrías hacer en los próximos 6 meses · 2 años · 5 años. Hoy las nombramos para que sepas dónde mirar.
Advertencia
Modo del Sprint 3: AIAS 2 (Planning). La idea NO es ejecutar las 4 fronteras hoy · es mapearlas y elegir 1 que vas a explorar en tu compromiso de 3 a 6 meses después del curso.
🎓 JC 1/4 · 🤖 Chatbots para divulgación · el paper que conversa (4 min)
La adopción: 57% (2024) → 84% (2025) de investigadores usan IA generativa; 45% → 62% para tareas de investigación/publicación.
Stack lean 2026: Elicit · scite.ai · NotebookLM · Custom GPT o Claude Project entrenado sobre tu propia tesis.
Cómo se ve un “paper-chatbot”:
- Cargás PDF del paper + dataset + código + audit logs.
- Definís system prompt con límites explícitos: “no inventes números, cita sección del paper, declara incertidumbre”.
- Publicás QR al chatbot en la descripción del video / overlay · cualquiera puede hacerle preguntas 24/7.
Caso documentado: Hake et al. (World Neurosurgery 2024) — Custom GPT sobre paper propio acelera Q&A pero arrastra sesgos del autor. Análisis de 140 resúmenes (Annals of Family Medicine 2024): mediana 90/100 calidad · 4 con alucinaciones graves que invierten interpretación (e.g. RCT abierto descrito como doble-ciego).
🎓 JC 1/4 · 🤖 Chatbots para divulgación · el paper que conversa (4 min) · cont.
Advertencia
3 reglas para tu paper-chatbot:
- System prompt público · publicalo junto al QR · “AI Use” extendida.
- Disclaimer de alucinación visible: “Este chatbot puede inventar · verificá toda cifra contra el PDF.”
- Audit de spin mensual · pediile a un peer que liste 10 outputs y marque ≥1 falso.
Consejo
Acción concreta después del curso:
Claude Project "Tesis_[Apellido]_2026":
- PDF tesis · dataset · código R/Python
- DAG H2 · PAP H3 · audit logs L1-L5
- system_prompt.md · disclaimer.md
- "ASK_ME_3" prompts ready para visitantes
→ Link al chatbot en el README.md del repo · próximo nivel del AEA Data Editor.
Cita ancla: (Hake et al., 2024) · (Saasnik, 2026) · (Family Medicine, 2024). La adopción está pasando · la disciplina ética no.
🎓 JC 2/4 · 🎙️ Podcast científico · NotebookLM Audio Overviews (4 min)
La explosión 2024–2025: +2 millones de usuarios activos de NotebookLM Audio Overviews. Desde septiembre 2025 disponible en 80+ idiomas (incluido español LATAM).
Formatos: Deep Dive (15-20 min · 2 voces) · Brief (5 min) · Critique (adversarial) · Debate (pro/contra).
El podcast académico tradicional sigue creciendo:
- The Mixtape with Scott (Cunningham · causal inference).
- ResearchInBrief (AEA) · NBER This Week.
- LATAM emergente: Empíricos en Latam, Estudio Diferentes.
Validación dominio-específica:
- Flynn (AGU/Wiley 2025) evalúa Audio Overviews en ciencias planetarias: resúmenes “engaging” y “fairly accurate” — pero omiten métodos y nuance.
- Riesgo APA 2025: el formato auditivo eleva engagement inicial pero deprime profundidad de comprensión (cognitive offloading).
🎓 JC 2/4 · 🎙️ Podcast científico · NotebookLM Audio Overviews (4 min) · cont.
Advertencia
El espejismo del audio:
El oyente reconoce conclusiones sin entender metodología. Si tu paper es DiD staggered, el podcast NotebookLM va a decir “effect of X on Y” — sin nombrar Goodman-Bacon, sin Cross-check CS, sin sensitivity.
→ Sirve para atraer, no para defender.
Consejo
Workflow recomendado MAE:
- Generá tu Audio Overview en español LATAM (≤12 min) desde NotebookLM.
- Subilo a SSRN/RePEc como track adicional al paper.
- En la página del paper · link al PDF metodológico justo al lado del audio.
- En tu LinkedIn / Twitter académico · audio + thread + link al repo.
→ El podcast NO sustituye el paper · lo distribuye.
Cita ancla: (Flynn, 2025) · (Google NotebookLM, 2025). La pregunta práctica: ¿tu tesis tiene un Audio Overview en español por defecto? · Si no, estás dejando audiencia en la mesa.
🎓 JC 3/4 · 🧊 Data Physicalization · el prop que se ve en cámara (4 min)
Definición canónica (Jansen et al., 2015):
“Artefacto físico cuya geometría o material codifica datos.”
No es decoración · es un canal de comunicación distinto del visual.
Casos icónicos:
- 🌡️ Warming stripes de Ed Hawkins (2018) — entraron al MoMA en 2025 como pieza de comunicación científica (Hawkins et al., 2025).
- 🌌 Star Listener — instalación táctil-sonora de datos astrofísicos en biblioteca pública (evaluada in-situ a 2 meses · Behaviour & Information Technology vol.43(14) 2024).
- 🏠 Perera et al. 2024 — physicalizations de consumo energético en 15 hogares · cambiaron comportamiento medible.
- 💉 COVID Memorial · bandera con un punto por cada muerte (Suzanne Brennan Firstenberg).
Frontera de catálogo: dataphys.org (Yvonne Jansen · Pierre Dragicevic · Inria).
🎓 JC 3/4 · 🧊 Data Physicalization · el prop que se ve en cámara (4 min) · cont.
Consejo
Para tu video poster · idea concreta:
¿Cuál es el prop de 10 cm que sostenés frente a la cámara en el momento del hallazgo?
- 🖨️ 3D print del coeficiente · alza altura proporcional al ATT cuando narrás la magnitud.
- 🧱 Bloques apilables que representan magnitudes por subgrupo · revelados de a uno.
- 🧵 “Stripe textil” del efecto temporal · 1 fila por año · color por magnitud.
- 📦 Caja de muestras con N realista (e.g. 100 frijoles = 100 municipios tratados) volcada sobre la mesa.
Costo marginal: $0-20. Diferenciación frente a un video de láminas planas: enorme. Quien revisa se acuerda del prop mucho después de olvidar tu p-value.
Advertencia
Lo que NO es physicalization:
- ❌ Un PDF impreso a tamaño grande.
- ❌ Una infografía en cartón.
✅ Algo que se toca y donde la geometría/material codifica datos.
🎓 JC 4/4 · 🧠 Ciencias del comportamiento al servicio de la comunicación (4 min)
EAST framework del Behavioural Insights Team UK (Hallsworth et al., 2024) · ~350 citaciones académicas · republicado 2024 con casos de 10 años:
¿Es fácil de escanear? ≤3 clicks · ≤2 minutos.
¿Hay un número grande en la 1ª línea?
¿Menciona una norma · grupo de referencia?
¿Está vinculado a una decisión pública vigente?
El sesgo del autor sobre su propio paper:
- Hardwicke et al. 2024 (Hardwicke et al., 2024) (arXiv 2502.20581): ~19% de las afirmaciones citantes en psicología tergiversan el paper citado.
- Equivalente del sunk-cost: el autor sobre-vende su propio efecto.
🎓 JC 4/4 · 🧠 Ciencias del comportamiento al servicio de la comunicación (4 min) · cont.
Nota
🧠 La ciencia del comportamiento al servicio de la comunicación
Tres ideas clave:
- Framing effects (Tversky-Kahneman): la misma estadística enmarcada distinto produce decisiones opuestas. “Sobrevivirán 1 de 3” vs “morirán 2 de 3” — mismo número, distinta acción del lector.
- Norma social (Cialdini): citar lo que otros pares hacen mueve más que apelar a autoridad. “7 de 10 economistas LATAM ya usan CS estimator” > “Callaway-Sant’Anna 2021 propuso…”
- Tiempo y atención (Thaler): el lector decide en 3 segundos si sigue leyendo. La primera frase del abstract es la palanca del paper completo.
→ EAST es el vehículo operativo de estos 3 hallazgos · no es marketing, es diseño cognitivo aplicado a tu paper.
Consejo
Auditoría de spin de tu propio paper (5 min · pedile a un peer):
- Lee 3 frases del abstract.
- Marcá cada una como CLAIM JUSTIFICADO (datos lo respaldan) o SPIN POTENCIAL (¿hay que matizar?).
- Si hay al menos un spin, reescribe antes de grabar.
Cita ancla: (Hallsworth et al., 2024) · (Hardwicke et al., 2024). EAST aplicado al abstract = 60 segundos · transformación enorme.
📌 Síntesis · cuatro fronteras · una hoja de ruta (1 min)
| Frontera | Ganancia | Riesgo principal | Acción 3-6 meses |
|---|---|---|---|
| 🤖 Chatbot del paper | Q&A 24/7 · acceso amplificado | Alucinación que invierte interpretación | Claude Project + disclaimer + audit mensual |
| 🎙️ Audio Overview | Reach × 100 · diferenciación SSRN | Cognitive offloading · método invisible | NotebookLM ES-LATAM + link al PDF |
| 🧊 Physicalization | Diferenciación profesional total | Que se vea como manualidad, no como datos | Objeto 10 cm · 3D print o textil · costo $0-20 |
| 🧠 Ciencias del comportamiento | Auditoría de spin · honestidad · framing | EAST sin teoría se queda en marketing | Auditoría EAST + peer-spin check antes de grabar |
Compromiso a 3–6 meses (lo firmas en S08): elegí 1 de las 4 fronteras y comprometete a implementarla en tu paper. La maestría termina · esta agenda profesional empieza.
🔍 Hallazgos del Lab L5 · ¿quién decidió? (8 min)
audit/L5-meta.md
08:00
Consejo
Lo que encuentren aquí alimenta la pregunta de cierre de mañana: “¿Qué hizo la IA por ti que tú no hiciste?”
🛠 Cierre logístico · lo que falta para el H4
13 minutos · asignación del peer review · video póster v1 · checklist
🤝 Peer review · asignación + reglas (5 min)
Cada estudiante revisa 2 video pósteres. Con 4 personas usamos una rueda: cada quien revisa a las dos personas siguientes del orden sorteado.
- Plazo: jue 26/11 · 23:59, dos días después de la entrega del H4.
- Entrega: 1 a 2 páginas por video + 1 pregunta para cada autor.
Rúbrica del peer review (3 dimensiones):
| Dimensión | Peso |
|---|---|
| Calidad de los comentarios | 50% |
| Calibración con el instructor | 30% |
| Honestidad | 20% |
Advertencia
Modo AIAS 1 obligatorio:
- Cero IA en la revisión. Si hay evidencia de IA en tu texto, se descalifica tu peer review.
- Revisas con tu propio criterio. Por eso vale 10 %.
- Es la prueba de que aprendiste a leer críticamente una propuesta.
→ El autor responde tu pregunta por escrito y sin IA en audit/respuestas-defensa.md.
🛠 Video póster v1 · checklist + commit obligatorio (5 min)
Antes de cerrar la sesión · cada estudiante valida:
- Título ≤ 12 palabras · incluye contribución
- Pregunta H1 visible en 5 segundos
- Gráfico dominante · pasa test 5s
- Magnitud específica (no "significativo")
- Limitación honesta · 1 frase
- QR al repo público
- "AI Use Disclosure" visible (link)
- DOI Zenodo (opcional)
- Modo AIAS dominante declarado por hito
- Audit logs L1-L5 commiteados
🎯 Checklist del video póster · entrega mar 24/11 · 23:59 (3 min)
Qué entregás · artefactos digitales:
- 🎬 Video poster 3–5 min subido a YouTube/Vimeo (unlisted)
- 💻 Repo H4 público ·
make allcorre limpio en máquina virgen - 📱 QR al chatbot (si lo armaste) en descripción del video
- 🧊 Prop visible en el video (JC 3 · bonus de diferenciación)
- 📋 Declaración AI Use visible (overlay del video + repo)
Qué tu video poster NO contiene:
- 🚫 Voz IA generada · es TU voz narrando
- 🚫 Slides hechos 100% por IA sin auditar
- 🚫 Citas inventadas · alucinaciones · números no verificados
- 🚫 Spin del hallazgo (auditá con Sprint 2 JC 4)
→ Video poster = AIAS 1 en narración · sin voz sintética · sin guion escrito por IA.
🎯 Checklist del video póster · entrega · cont. mar 24/11 · 23:59 (3 min)
Advertencia
3 preguntas que sus peer reviewers (y JC) les pueden hacer · respondan en el repo:
- “¿Qué hizo la IA por ti que tú no hiciste?” — honestidad medida vs declaración.
- “¿Qué patrón problemático detectaste en tu propio thread del curso (L5)?” — meta-auditoría.
- “Si quitamos la IA · ¿qué párrafo / decisión / gráfico no existiría?” — ese párrafo es el que defendés mejor.
→ Las respuestas van en audit/respuestas-defensa.md del repo · NO en comentarios del video.
Consejo
Ensayo de 90 segundos · hacelo ANTES de grabar: - En tu teléfono, grabate explicando tu hallazgo principal en 90 seg sin notas. - Si necesitás más de 90 seg, no entendiste tu propio trabajo · simplificá. - Si necesitás IA para escribir el guion, el video no es tuyo.
🎓 Mañana (S08) el video póster se construye en taller. Lo entregan el mar 24/11 · 23:59. Lo que armaron en dos semanas vive en un video de 5 minutos. La narración, la declaración y el repo son suyos.
Sprint 4 · 🎬 Taller de guion + gráfico dominante
45 minutos · lo que salía de casa ahora se hace en aula · llegan a S08 con un borrador
📍 Estructura del Sprint 4 (45 min)
45:00
Guion v1 · plantilla
- Gancho (30 s): la frase o la cifra que dice por qué importa.
- Hallazgo esperado (2 min): el gráfico dominante y una magnitud.
- Método (1 min): del DAG al estimador.
- Implicación (1 min): para quién y qué cambia.
- Limitación + uso de IA (30 s).
Consejo
IA en este sprint (modo AIAS 2):
- Pídanle que critique el guion: “¿qué sobra?, ¿dónde me pierdo?”.
- No le pidan que lo reescriba.
- Registren en el audit log qué sugerencia aceptaron y cuál rechazaron.
Nota
Formato híbrido: la persona en virtual comparte pantalla para la prueba de 5 segundos con su par.
Sesión 8 · S08 · sáb 21/11 · 🎬 Taller de video póster + cierre
6 h presenciales · 38-303 · mañana: construir el video póster · tarde: estreno, pregunta de cierre y manifiesto
📍 Cómo trabajamos hoy · mañana · 8:00–12:00
| Hora | Min | Bloque | Foco | JC·Act |
|---|---|---|---|---|
| 08:00 | 15 | Apertura · 🎤 | Reglas del taller · guion y voz propios · revisión de los commits de ayer | 10·5 |
| 08:15 | 50 | Taller 1 · ✍️ | Guion IMRaD final de 3 a 5 min · lectura en voz alta con cronómetro | 5·45 |
| 09:05 | 40 | Taller 2 · 📊 | Gráfico dominante final (Schwabish, 2021) · prueba de 5 segundos | 5·35 |
| 09:45 | 15 | ☕ Break | ||
| 10:00 | 60 | Taller 3 · 🎙️ | Grabación de ensayo · screencast + voz · subtítulos | 0·60 |
| 11:00 | 55 | Taller 4 · 🤝 | Retroalimentación de pares en vivo · 4 borradores × 11 min + ajustes | 10·45 |
| 11:55 | 5 | Cierre mañana | Qué cambia cada uno antes de la grabación final | 5·0 |
| 12:00 | 60 | 🍽 Almuerzo |
📍 Cómo trabajamos hoy · tarde · 13:00–15:00
| Hora | Min | Bloque | Foco | JC·Act |
|---|---|---|---|---|
| 13:00 | 20 | 🎬 Estreno | 60 s de cada borrador · una fortaleza y una pregunta del grupo | 5·15 |
| 13:20 | 25 | 🎯 Pregunta | “¿Qué hizo la IA por ti que tú no hiciste?” · sin IA al frente · 5 min cada uno | 5·20 |
| 13:45 | 10 | ☕ Break | ||
| 13:55 | 35 | Retrospectiva | Auto-evaluación + ¿cómo lo harían hoy? · encuesta de cierre | 10·25 |
| 14:30 | 25 | Cierre ritual | El arco S01 ↔︎ S08 · manifiesto IA² personal firmado | 10·15 |
| 14:55 | 5 | Entregas | H3 dom 22/11 · 23:59 · H4 mar 24/11 · 23:59 · Peer jue 26/11 · 23:59 | 5·0 |
Nota
Formato híbrido: la persona en virtual sigue el taller por videollamada, comparte pantalla para su ensayo y responde la pregunta de cierre con cámara encendida.
🎬 Anatomía del video póster · lo que sale de hoy
✍️ Mañana · guion y gráfico - Guion de 600 palabras como máximo (3 a 5 min hablado con pausa) - Cinco bloques: gancho, hallazgo, método, implicación, limitación - Gráfico dominante que pasa la prueba de 5 segundos - Láminas Quarto revealjs con render limpio
🎙️ Grabación · screencast con voz - Tu voz, nunca voz sintética · Loom, OBS o QuickTime - 3 a 5 min cronometrados; si pasas de 5, recortas - Subtítulos activados - Ensayo hoy · grabación final en casa
📁 Entrega · mar 24/11 · 23:59 - Enlace al video (YouTube o Vimeo no listado) en 04-video-poster/README.md - Repo H4 público · make all corre en una máquina limpia - Declaración de uso de IA en el video y en el repo - Respuestas a tus 2 peer reviewers después de jue 26/11 · 23:59
🤝 Taller 4 · Retroalimentación de pares en vivo (55 min)
11:00
Consejo
Regla del taller: el comentario se hace sobre el minuto exacto del video. “Está bien” no cuenta como retroalimentación.
🎯 La pregunta de cierre · en vivo y sin IA al frente
“¿Qué hizo la IA por ti que tú no hiciste?”
Cómo se lee la respuesta:
| Respuesta | Lectura |
|---|---|
| “Nada · todo lo hice yo.” | 🚩 Bandera roja. O no es cierto, o no usaste las herramientas del curso. |
| “Todo · sin IA no habría hecho nada.” | 🚩 Bandera roja. La IA no es autora; la responsabilidad no se delega. |
| “Buscó literatura que audité en el L1. Programamos juntos en el L4 y revisé cada línea. Estos tres párrafos los reescribí cuatro veces porque la IA los dejaba genéricos.” | ✅ Respuesta honesta. Operaste en AIAS 2 a 4, declaraste el modo y mantuviste la autoría. |
→ La pregunta busca confirmar que tu declaración de uso de IA coincide con tu uso real. Cinco minutos por persona, sin notas generadas.
Retrospectiva del curso · 35 min
Los 4 ejes del curso · autochequeo
Autochequeo, sin escalas: marca lo que ya puedes hacer. Lo que quede vacío es tu tarea de los próximos tres meses.
Eje 1 · Pregunta investigable: - [ ] Sé diferenciar pregunta investigable vs consultoría - [ ] Mi pregunta H4 cumple criterios FINER/COPS - [ ] Sé que puedo equivocarme · espacio de revisión
Eje 2 · Identificación causal: - [ ] Mi DAG es defendible - [ ] Reconozco good vs bad controls - [ ] Mi método empata con mi pregunta de identificación - [ ] Sé qué pre-trends NO son identificación
Eje 3 · Comunicación + reproducibilidad: - [ ] Mi video poster pasa la prueba 5 segundos - [ ] Mi repo es AEA Data Editor compatible - [ ] Tengo gráfico dominante claro - [ ] Puedo traducir a policy brief 2pp
Eje 4 · Ética IA²: - [ ] Mi declaración AI Use está en el repo - [ ] Conozco AIAS 1-5 y cuándo aplica cada uno - [ ] Detecté ≥1 ilusión Messeri-Crockett en mi proceso - [ ] Sé que la detección falla · declaración es el camino
Encuesta de cierre · seis preguntas abiertas
Sin escalas y anónima. Se responde hoy o hasta una semana después de S08. Es la base de la retro de la cohorte.
- ¿Qué se te queda en la cabeza al terminar este curso?
- ¿Qué cambió en tu manera de pensar la investigación?
- ¿Qué herramienta de IA vas a seguir usando, y cómo?
- ¿Qué le quitarías al curso?
- ¿Qué le agregarías?
- ¿Cómo le describirías el método del curso a un colega?
La pregunta de cierre · ¿cómo lo harías hoy?
Si hace dos semanas les hubiéramos dicho “haz una propuesta de tesis con IA”,
lo habrían hecho con miedo o con hype.
Hoy, ¿cómo lo harían?
Esa diferencia es lo que aprendieron. Anoten la respuesta en su autochequeo. En tres meses la vuelven a leer.
Pregunta-control individual: Si tuviera que hacer un segundo trabajo de grado mañana — sin este profesor · sin este syllabus · solo con la IA y un objeto de estudio — ¿qué haría primero?
→ La respuesta a esa pregunta es el curso destilado.
Cierre ritual · manifiesto IA² firmado
25 minutos · el arco S01 ↔︎ S08 se cierra
Lo que se llevan del curso · destilado
Conceptual:
- Investigación = método + criterio, no herramientas.
- IA cambia velocidad, no método.
- Diseño antes que estimación.
- Reproducibilidad es la definición operativa de hacer ciencia.
- Ética IA² es honestidad sobre las ilusiones, no policía.
Operativo:
- Quarto + git como infraestructura.
- DAG explícito + adjustment sets.
- Pipeline literatura humano+IA + caza alucinaciones.
- DiD moderna + LLMs como datos (3 diagnósticos).
- Audit log AIAS en cada entrega.
- Declaración AI Use estilo ICMJE.
Lo que se llevan del curso · destilado · cont.
Crítico:
- LLMs alucinan citas · verificá todo. (Buchanan et al., 2024)
- “Más controles ≠ mejor.” (Cinelli et al., 2024)
- TWFE clásico está roto en staggered. (Goodman-Bacon, 2021)
- LLMs como datos = nueva fuente de error correlacionado. (Ludwig et al., 2025)
- 4 ilusiones de Messeri-Crockett operan siempre. (Messeri & Crockett, 2024)
- Detección no funciona · declaración sí. (Perkins, Roe, et al., 2024)
Para la vida:
- Tu tesis es el primer paper, no el último.
- La transparencia es competencia profesional, no virtud.
- La IA es colaborador junior — útil, pero requiere supervisión humana.
La pregunta del curso · respondida
La pregunta que abrió U1 (lun 09/11):
Si la IA puede aumentar mi velocidad 5×, ¿qué hago yo · qué hace la IA · y dónde está la frontera ética?
La respuesta destilada de las 8 sesiones:
| Yo hago | La IA hace | Frontera ética |
|---|---|---|
| Pregunta (FINER/COPS) | Sugerir variantes | Pregunta es mía o no es investigación |
| DAG + identificación | Criticar good/bad controls | Causalidad es decisión humana |
| Lectura crítica de papers | Resumen + búsqueda | Las 4 ilusiones de Messeri-Crockett |
| Diseño metodológico | Pair programming código | Si no audito línea por línea, no es mío |
| Interpretación de hallazgos | Borrador de párrafos | La interpretación es indelegable |
| Responder a pares y la pregunta de cierre | NADA | AIAS 1 · sin IA al frente |
| Declarar uso honesto | NADA | Declaración es responsabilidad indelegable |
El arco · S01 abrió, S08 cierra
S01 · lun 09/11 · 4h presencial
Abrimos con dos preguntas en pizarra:
“¿Engelbart o Turing?”
“¿Augmentación o automatización?”
Firmaron el Manifiesto IA² del curso — el público. Era una abstracción.
S08 · sáb 21/11 · 6 h presencial
Cierran con su video póster y respondiendo sin IA al frente. Ahora la abstracción tiene cuerpo:
“¿Quién decidió esto?”, tu Lab L5.
“¿Qué hizo la IA por ti que tú no hiciste?”, la pregunta de hoy.
Ahora firmás el Manifiesto IA² personal — el privado. Lo que valió la pena.
No estás compitiendo con la IA. Estás compitiendo con economistas que saben usar IA bien.
Hoy entendiste la diferencia entre las dos competencias.
Manifiesto IA² personal · texto a firmar
Nota
Yo, ___________________________________ (nombre completo), al cierre del curso EC0744 · Seminario de Investigación · MAE · Universidad EAFIT · sáb 21/11 de 2026, firmo este manifiesto personal:
Reconozco la diferencia entre augmentación (Engelbart 1962) y automatización (Turing 1950). Elijo la primera como práctica profesional.
Mi tesis es el primer paper, no el último. El repo público que entregué vivirá al menos seis meses.
La IA no es mi autora. Es mi colaborador junior. Yo soy responsable indelegable de cada decisión científica que firme con mi nombre.
Declararé honestamente el uso de IA en mi tesis, working papers y futuras publicaciones — conforme a (International Committee of Medical Journal Editors, 2023) y (Nature Editorial, 2023).
Reconozco las 4 ilusiones de Messeri-Crockett (profundidad · objetividad · amplitud · comprensión) y me comprometo a auditarlas cuando aparezcan en mi proceso.
Explicaré sin IA lo que presenté hoy: mi propuesta. La augmentación no se transfiere: el juicio es mío.
Firma: ___________________________ Fecha: ______________ Repo: github.com/_____/_____
→ Plantilla completa en materiales/manifiesto-personal-ia2.md · se firma hoy, en el aula.
El momento
Cuatro personas entraron a este curso hace dos semanas.
Cuatro economistas salen hoy.
Lo que cambia entre esas dos frases es lo que firmaron.
🎓 Tu propuesta de tesis es el primer paper. 🎓
🎓 No el último. 🎓
Gracias · y nos vemos en 3 meses
EC0744 · Seminario de Investigación · MAE EAFIT · cohorte 2026-2
9–21 de noviembre de 2026
4 economistas · 8 sesiones · 4 hitos + peer review · 5 labs IA² · 4 video pósteres
🎓 Gracias por estas dos semanas. 🎓
Materiales abiertos del curso (CC BY 4.0):
- 📂
jcmunozmora.github.io/curso_seminario_investigacion - 📂 Tu propio repo · público mínimo 6 meses
- 📂 Tu autochequeo + encuesta de cierre + firma del compromiso
Próximas lecturas · sigan creciendo
Nota
Para profundizar después del curso:
- (Cunningham, 2021) Mixtape — completar capítulos no vistos (DiD, IV, RDD profundos).
- (Huntington-Klein, 2022) The Effect — refuerzo en diseño causal.
- (Hernán & Robins, 2020) What If — formalismo causal (Harvard, libre).
- (Pearl & Mackenzie, 2018) Book of Why — pensamiento causal · puente filosófico.
- (Korinek, 2024) — actualización viva del rol LLM en investigación económica.
Lecturas críticas que no pueden saltarse:
- (Messeri & Crockett, 2024) — Nature · ilusiones epistémicas.
- (Ludwig et al., 2025) — frontera 2025 · LLMs como datos.
- (Bender et al., 2021) — fundación crítica · sesgos heredados.
- (Buchanan et al., 2024) — citas alucinadas.
- (International Committee of Medical Journal Editors, 2023) · (Nature Editorial, 2023) · (Perkins, Furze, et al., 2024) — ética IA² operativa.
- (Schwabish, 2021) · (Wilke, 2019) · (Heath & Heath, 2007) — comunicación de la ciencia.
Referencias
EC0744 · Seminario de Investigación Aplicada Universidad EAFIT · Escuela de Finanzas, Economía y Gobierno 2026-2