Revisión de literatura asistida por IA
Tipos de literatura · pipeline 4-fases · Lab L1 caza de alucinaciones
Universidad EAFIT · Escuela de Finanzas, Economía y Gobierno
10 de noviembre de 2026
Bienvenidos
Unidad 4 — Revisión de literatura con IA
S02 · mar 10/11 · 18:00–22:00 · 4 h · Aula 38-302
Nota
Pregunta guía: ¿Cómo construyo un mapa de evidencia confiable cuando la IA inventa citas (>30 % en ChatGPT, 2023) y, aun con agentes de 2026, cita fuentes reales que no dicen lo que afirma?
Lo que se llevan al final de S02:
- ✅ 15–25 papers de su tema, verificados con DOI
- ✅ Evidence Map v0
- ✅ 1 contradicción entre papers
- ✅ Audit log L1 con su tasa personal de alucinación
- ✅ 2 fichas de lectura activas
Cómo trabajamos hoy — 4 Sprints
| Bloque | Tema | 🎓 JC | 🔧 Act | Fin |
|---|---|---|---|---|
| Sprint 1 · ¿QUÉ? | Propósitos · diana de 4 capas · pirámide de evidencia · primera búsqueda con tus 3 palabras clave | 25 | 20 | 18:45 |
| ☕ Descanso 1 | 10 min | 18:55 | ||
| Sprint 2 · ¿CÓMO? 🧪 | PRISMA mínimo · 2026: la cita infiel · 2 caminos IA · Lab L1 (45 min) | 25 | 45 | 20:05 |
| ☕ Descanso 2 · café largo | 15 min | 20:20 | ||
| Sprint 3 · 📖 Leer | Keshav en 3 pasadas · 4 modos de lectura con IA · ficha activa | 20 | 20 | 21:00 |
| Sprint 4 🏗️ | Evidence Map v0 + 1 contradicción entre papers | 10 | 40 | 21:50 |
| Cierre | Cada uno dice su contradicción y su tasa · próximo S03 | 5 | 5 | 22:00 |
Regla del aula: la IA acelera la búsqueda; la verificación es de ustedes. Son 4: todos hablan en cada cierre.
Consejo
Lecturas hoy: (Buchanan et al., 2024) · (Onweller et al., 2026) · (Khraisha et al., 2024) · (Grant & Booth, 2009).
El bridge · de tu tema (S01) al mapa del campo (S02)
En esta cohorte leemos antes de preguntar. Ayer salieron con un tema y una intuición. Hoy recorremos lo que el campo ya sabe sobre ese tema. Mañana (S03) formulamos el problema contra esa literatura, y el jueves (S04) lo escribimos en el PRON.
Tema + intuición
+ 3 palabras clave
Tipos · peer review
+ pirámide + ejemplos
A·V·R · pipeline
+ Lab L1 caza
Leer en tres pasadas
+ ficha activa
Evidence Map v0
+ 1 contradicción
Lo que traen de S01:
- ✅ Su tema en una frase (todavía no es pregunta).
- ✅ 3 palabras clave: el resultado que les importa, la causa que sospechan y la población.
- ✅ Una intuición: “creo que X afecta a Y en Z”.
Advertencia
Sin pregunta, buscamos con la diana y paramos en 15 a 25 papers. Hoy buscamos dónde discute el campo.
Consejo
Lo que sale de hoy alimenta toda la semana:
| Hoy (S02) | Se usa en |
|---|---|
| 15–25 papers verificados con DOI | S03: el problema se apoya en cifras reales |
| 1 contradicción entre papers | S03: candidata a gap o a supuesto que problematizar |
| Evidence Map v0 | S04: §2 y §3 del PRON · S05: cada flecha del DAG |
| Tasa personal de alucinación (Lab L1) | Audit log de H1 |
Sprint 1 · ¿QUÉ buscar?
18:00 → 18:45 · Propósitos · diana de 4 capas · pirámide de evidencia · primera búsqueda
📍 Estructura del Sprint · 5 secciones
Consejo
Convergencia internacional: estructura clásica (Grant & Booth, 2009; Webster & Watson, 2002) · operativizada para tesis MAE con stack moderno (OpenAlex · NotebookLM · bibliometrix).
🎓 JC 1/3 · Propósitos de la revisión · 5 usos centrales (6 min)
Antes de crear conocimiento, conocemos el que existe. El propósito: comprender la literatura, con sus fortalezas y debilidades.
Tipo de revisión por propósito:
| Mapeo | Cuanti | Crítica | Justif. tesis | |
|---|---|---|---|---|
| Sistemática | ✅ | ✅ | Posible | ⚠️ over-kill |
| Rapid | ✅ | ⚠️ | ✅ | ✅ ideal |
| Living | ⚠️ | ✅ | Posible | ⚠️ |
Consejo
Para MAE: rapid review estructurada con flujo reproducible. Estructura + transparencia + replicabilidad sin la inversión de una sistemática completa.
🎣 Hook · “A gap in the literature”
Advertencia
El gap fácil casi nunca es gap.
“Encontré un vacío en la literatura” suele significar “no busqué bien”.
El gap real se construye con:
- ✅ Query booleana documentada
- ✅ Flujo reproducible (n inicial → n final)
- ✅ Triangulación de fuentes
- ✅ Verificación de citas (Lab L1)
🎓 JC 2/3 · Tipos de literatura · ¿para qué te sirve cada capa? (4 min)
Una revisión de literatura no es una sola cosa. Cada capa de tu tesis pide un tipo distinto de lectura. La diana abajo te dice qué leer para qué.
Consejo
Regla práctica: 80% de tu lectura alimenta ① + ②. Pero NO descuidés ③ (métodos) ni ④ (estilo): la diferencia entre tesis buena y mediocre suele estar ahí.
🎓 JC 3/3 · Pirámide de evidencia · ¿qué tipo de paper pesa más? (6 min)
No todos los papers pesan igual. La pirámide ordena los estudios por rigor causal.
Cómo usar la pirámide:
- 🔺 Cima (meta-análisis · RCT): para efectos y outcomes causales · pesa más en review.
- 🟢 Mitad (longitudinales · CT): para mecanismos y heterogeneidad.
- 🔻 Base (caso · opinión · grey): para contexto y motivación · NO para inferir efectos.
Advertencia
Trampa común: citar un blog como evidencia de efecto causal. Sirve para problematizar, no para concluir.
🔧 Actividad S1 · Mapear tu tema por capa de la diana (20 min)
Producto: la primera tabla de tu tema, con hasta 5 papers por capa de la diana, clasificados por pirámide y fuente.
| Min | Tarea |
|---|---|
| 0–8 | Primera búsqueda en OpenAlex, Scite o Google Scholar con tus 3 palabras clave. Nada de chatbots todavía: buscador de papers. |
| 8–12 | Ubica cada paper en una capa de la diana (①②③④). |
| 12–15 | Asigna nivel de pirámide y fuente (revista arbitrada · working paper · literatura gris). |
| 15–18 | Marca qué capa está más vacía: esa es la prioridad del Sprint 2. Escribe “FALTA: tipo X de literatura”. |
| 18–20 | En pares (son 4: dos parejas), cada uno le dice al otro si el balance entre capas es razonable. |
🔧 Actividad S1 · plantilla de la tabla
Plantilla mínima (Quarto · Notion · spreadsheet):
| Capa | Paper | Pirámide | Fuente |
|---|---|---|---|
| ① Problemas | … | Caso/Grey | WP/Prensa |
| ② Objetivos | … | Meta/RCT | Peer |
| ③ Métodos | … | RCT/Long | Peer |
| ④ Estilo | … | — | Top journal |
Consejo
Si en una capa no tienes 5 papers todavía, deja la fila vacía y anota qué tipo de paper buscar. Eso orienta la búsqueda del Sprint 2.
Advertencia
No llenes por llenar. Mejor 3 papers verificados que 5 inventados. El Sprint 2 corrige los huecos.
Sprint 2 · 🧪 ¿CÓMO buscar? + Lab L1
18:55 → 20:05 · PRISMA mínimo · la cita infiel · 2 caminos IA · Lab L1 (45 min)
🎓 JC 1/3 · Recomendaciones para una revisión moderna + PRISMA (4 min)
5 recomendaciones operativas:
Consejo
PRISMA 2020 (Page et al., 2021) es la guía estándar de reporting: 27 ítems + diagrama de flujo (Identificación → Tamizado → Elegibilidad → Inclusión). No te dice qué papers son mejores — te dice cómo documentás tu proceso para que otra persona pueda reconstruirlo.
Advertencia
Y si usás IA en alguna fase: PRISMA-DFLLM (Susnjak & Hwang 2024) extiende con 7 ítems adicionales — modelo + prompt + ground truth + métricas. (Susnjak & Hwang, 2024)
2026 · El problema cambió de forma
JC · 4 min · evidencia nueva
2023 · la cita que no existe
ChatGPT inventaba más del 30 % de las referencias en economía (Buchanan et al., 2024).
2026 · la cita que existe y no dice eso
- Agentes de investigación profunda: entre 3 % y 13 % de las URL citadas probablemente nunca existieron, y alucinan más que los modelos con búsqueda simple (Rao et al., 2026).
- Los mejores modelos dan enlaces válidos en más del 94 % de los casos, pero la fuente respalda la afirmación solo entre 39 % y 77 % (Onweller et al., 2026).
- Más búsquedas no mejoran: al pasar de 2 a 150 llamadas, la exactitud cae cerca de 42 %.
Lo que cambia en el Lab L1
Hoy cazamos dos presas:
- La cita fantasma: no tiene DOI o el DOI lleva a otro paper.
- La cita infiel: el paper existe, pero no dice lo que la IA afirma. Se caza leyendo el resumen y la tabla de resultados.
Un DOI que abre no es una verificación.
🤔 Reflexión 1/2 · El bingo de alucinaciones IA (1 min)
Antes del Lab L1, miremos qué pasa cuando dejamos a la IA buscar sin verificar.
Buchanan, Hill & Shapoval (2024) — American Economist: 200 citas pedidas a ChatGPT sobre tópicos de economía · verificadas en Scopus + WoS + Google Scholar.
>30% no existían. Autores reales con títulos inventados. Títulos reales con autores incorrectos. Journals reales con artículos que nunca se publicaron.
Consejo
Y no es solo Buchanan. Scherbakov et al. (2025, JAMIA) revisaron 76 papers que aplican LLMs a SR (2020–2024): <40% validan outputs contra humanos. La trampa estructural es ausencia de verificación, no solo alucinación. (Scherbakov et al., 2025)
Advertencia
Lo más peligroso: las alucinaciones son plausibles. Un revisor no-experto no las distingue. → Motivación directa del Lab L1. (Buchanan et al., 2024)
🤔 Reflexión 2/2 · Prompt malo vs bueno (1 min)
Dame 10 referencias seminales
sobre [tu tema] en los últimos
5 años con autor, año, título,
journal y DOI.
Dame hasta 10 referencias sobre
[tu tema] (post-2020). Por cada
una: autor · año · journal · DOI.

REGLAS:
1) Si no estás 100% seguro de
   algún dato, escribí [VERIFY]
   en vez de inventar.
2) Antes de listar, decime qué
   datos vas a tener que verificar.
3) Prefiero 5 reales que 10
   plausibles.
Consejo
Para verificación profunda (RAG): subí tus PDFs a NotebookLM · “Solo desde estos PDFs, lista los 5 papers que más se citen entre sí sobre X. Da la página exacta.” Alucina menos, pero igual abres la página citada: la cita infiel también aparece con fuentes reales.
Ahora la prueba de fuego: el Lab L1 mide tu tasa personal de alucinación. Menos del 40 % de los estudios que usan LLM en revisiones validan lo que el modelo entrega (Scherbakov et al., 2025).
🎓 JC 2/3 · Camino 1 · IA vía prompting directo (3.5 min)
Camino 1: hablar directamente con ChatGPT, Claude o Gemini.
Anatomía de un buen prompt para lit search:
Plantilla prompt — palabras clave A·V·R + constraint:
Sos un investigador en economía
del desarrollo. Mi tema es:
[tu tema en una frase + 3 palabras clave].

Componentes A·V·R:
- Actores: [hogares, municipios...]
- Variables: [pavimento, IPM...]
- Relaciones: [efecto moderado...]

DAME: 10 papers seminales (2015+)
sobre estas relaciones, EN ORDEN
de impacto. Por cada uno:
autor · año · journal · DOI ·
diseño causal · 1 hallazgo.

REGLAS:
1. Si no estás 100% seguro de
   algún DOI, escribí [VERIFY].
2. Prefiero 5 reales que 10
   plausibles.
3. Marca grey vs peer-reviewed.🎓 JC 3/3 · Camino 2 · IA vía aplicaciones especializadas (3.5 min)
Camino 2: herramientas hechas para revisión de literatura. Cada una sirve a una fase distinta. Primero, descubrir y filtrar.
| Tool | Fase | ✅ Pros | ⚠️ Contras / cuándo NO |
|---|---|---|---|
| Elicit | ① Discovery + ② Screening | UI intuitiva · genera resúmenes · acepta preguntas naturales | Recall 39.5% vs trad. 94.5% (Lau 2025) · sesgo a indexados |
| Connected Papers | ① Discovery | Visualiza red de papers desde 1 seed · gratis · rápido | No genera nada nuevo · depende de Semantic Scholar |
| Research Rabbit | ① Discovery | Exploración iterativa · sugerencias laterales | Curva de aprendizaje · pago para features avanzados |
| Litmaps | ① Discovery + ④ Synthesis | Timeline + red de citas · "Spark" sugiere papers nuevos · alertas automáticas · alternativa visual a bibliometrix | 3 maps gratis · ~$10/mes para uso continuo · depende de OpenAlex/Semantic Scholar |
| Rayyan | ② Screening | Colaborativo · sugerencias ML · gratis · estándar SR | Setup pesado · pensado para SR formal · UI dated |
| Covidence | ② Screening + ③ Extraction | Workflow completo Cochrane · trazabilidad total | Pago institucional ($$$) · over-kill para tesis MAE |
🎓 JC 3/3 · Camino 2 · cont. · extraer y sintetizar
| Tool | Fase | ✅ Pros | ⚠️ Contras / cuándo NO |
|---|---|---|---|
| NotebookLM | ③ Extraction + ④ Synthesis | RAG con tus PDFs · citas con página · gratis · sin alucinaciones de citas | Máx 50 sources · no permite editar fuentes · Google login |
| Scite | ④ Synthesis / citation context | Smart citations: si una cita apoya, refuta o menciona | Suscripción · cobertura desigual fuera de salud |
| Consensus | ① + ④ Discovery + Synthesis | Pregunta natural · resume evidencia agregada | 5 papers gratis · sesgo a literatura médica · simplifica demasiado |
| bibliometrix (R) | ④ Synthesis | Reproducible · open source · gráficos publication-ready | Curva R · no es IA · requiere .bib limpio |
| ChatGPT / Claude | Cualquier fase | Versátil · contexto largo · iteración rápida | Alto riesgo alucinación · sin trazabilidad · ver Camino 1 |
Consejo
Regla operativa: no existe la herramienta perfecta. Triangula: Connected Papers o Litmaps para descubrir, Rayyan o Elicit para filtrar, NotebookLM para sintetizar. Evidencia: (Scherbakov et al., 2025) · (Bolaños et al., 2024).
🔧 Lab L1 · las dos presas (45 min)
Plantilla: materiales/lab-L1-caza-alucinaciones.md
Cronograma del Lab (45 min):
| Min | Tarea |
|---|---|
| 0–5 | Pide a la IA 10 citas con DOI sobre tu tema (plantilla A·V·R + [VERIFY]). |
| 5–20 | Presa 1 · la cita fantasma: ¿existe? DOI.org, OpenAlex o Scopus. |
| 20–35 | Presa 2 · la cita infiel: elige 4 que existen; lee resumen y tabla. ¿Dicen lo que la IA afirma? |
| 35–40 | Llena el audit log y calcula tus dos tasas: fantasmas sobre 10, infieles sobre las que existen. |
| 40–45 | Los 4 reportan (picker): las dos tasas y el caso más curioso, 1 min cada uno. |
🔧 Lab L1 · audit log y reporte
Consejo
Audit log mínimo: # · cita · ¿DOI resuelve? · ¿mismo paper? · ¿dice lo afirmado? · ✅ / 👻 / 🎭 · nota.
Advertencia
Honestidad estadística: si la verificación dice 👻 o 🎭, repórtalo así. Las citas que pasen las dos presas entran a tu Evidence Map del Sprint 4.
🎲 Picker · L1
🎤 Orden de reporte · los 4
Sprint 3 · 📖 Leer papers en la era de IA
20:20 → 21:00 · De PDF a ficha activa · lectura asistida con sentido
🎓 JC 1/3 · El método clásico · Keshav 3-pass 2007 (4 min)
Tres pasadas con profundidad creciente (Keshav, 2007). Sigue funcionando en la era IA, ahora más rápido.
Cómo se aplica con IA (delta):
| Pass | Sin IA | Con IA |
|---|---|---|
| 1 | Lees 4 secciones | 1 prompt → resumen + decide |
| 2 | 1 hora ficha manual | 20 min ficha + Q&A NotebookLM |
| 3 | 4–5 hrs sin atajo | Sin atajo · pero IA ayuda a debatir |
Advertencia
Pass 3 NO se delega. Si tu paper es central, leelo profundo · vos. La defensa de tesis se gana en pass 3.
🎓 JC 2/3 · Lectura asistida con IA · 4 modos (5 min)
No todo se hace igual. 4 modos de usar IA al leer · cada uno con su nicho.
Consejo
Mapeo con Keshav: Modo 🅰️🅲 para pass 1 · Modo 🅱️ para pass 2 · Modo 🅳 para síntesis · Pass 3 sigue siendo humano.
🎓 JC 3/3 · La ficha de lectura · artefacto activo (6 min)
No leas asistido sin escribir ficha. La ficha es lo que la IA re-lee después y lo que tú recuerdas en 6 meses.
Anatomía · 12 secciones canónicas:
[[ficha_otra]]Importante
3 razones para ESCRIBIR (no solo leer):
- Retención — escribir activa codificación profunda (no skimming).
- Re-uso — dentro de 6 meses, releerás la ficha 100×, el paper 1×.
- RAG-ready — la ficha es la fuente que NotebookLM cita en U5/U6.
🔧 Actividad S3 · Construir 2 fichas (con asistencia IA) (20 min)
| Min | Tarea |
|---|---|
| 0–2 | Elige 2 papers que pasaron el Lab L1, idealmente de niveles distintos de la pirámide. |
| 2–6 | Pasada 1 de Keshav sobre cada uno: título, resumen, figuras, conclusión. |
| 6–16 | Llena la ficha de cada uno. La IA puede extraer; tú verificas cada dato contra el PDF. |
| 16–18 | Opcional: sube PDFs y fichas a NotebookLM y haz 1 pregunta entre papers. Verifica la página citada. |
| 18–20 | En pares: ¿en qué no están de acuerdo tus 2 papers? Es la semilla de la contradicción del Sprint 4. |
Importante
Producto (en tu repo de tesis):
- ✅
fichas/con 2 archivos.mdde papers que pasaron el Lab L1. - ✅ Cita BibTeX de cada uno en
references.bib.
→ Insumo directo del Sprint 4.
Sprint 4 · 🏗️ Construir tu Evidence Map
21:00 → 21:50 · de papers verificados al mapa del campo
🎓 JC 1/1 · Anatomía del Evidence Map v0 · qué entregas (8 min)
intelectual
metodológica
geográfica
candidato
viva
Consejo
Aplicado al cuento Catatumbo:
- Núcleo: Banerjee-Duflo · Aker-Mbiti · Donaldson · Faber · Asher-Novosad.
- Periferia metodológica: DiD (Asher-Novosad) · IV-topografía (Faber) · RDD-frontera (Estrada-Vergara).
- Periferia geográfica: Camargo-Hoyos (Colombia) · Vargas (Putumayo) · CEDE WP series.
- Gap candidato: infraestructura × violencia activa — la mayoría asume contexto pacífico.
- Contradicción viva: Estrada-Vergara 2019 (+IPM) vs Camargo-Hoyos 2022 (sin efecto si conflicto activo).
Advertencia
Sin contradicción explícita tu tesis suena a confirmación. Si no la encuentras, busca en otro país, periodo o método.
🔧 Actividad S4 · Construir tu Evidence Map v0 (40 min)
Cronograma sugerido (flexible):
| Min | Tarea |
|---|---|
| 0–10 | Junta lo verificado de hoy: Sprint 1 + Lab L1 + fichas. Completa hasta 15–25 papers con DOI que resuelve. |
| 10–15 | Opcional: 3 papers semilla en Litmaps para ver quién cita a quién (guía en el apéndice). |
| 15–25 | Llena la plantilla del Evidence Map v0 (5 componentes, materiales/plantilla-evidence-map-v0.md). |
| 25–33 | Busca 1 contradicción: dos papers que dicen cosas distintas sobre lo mismo. Anota cuál, en qué y por qué crees que difieren (datos, método, población, periodo). |
| 33–38 | Escribe 1 párrafo (100–150 palabras): en qué coincide el campo y dónde discute. |
| 38–40 | En pares: ¿la contradicción se entiende sin explicarla? |
🔧 Actividad S4 · qué entregas hoy
Importante
Producto entregable (en tu carpeta de tesis):
- ✅ 15–25 papers verificados en
references.bib. - ✅ Tabla Evidence Map v0 (5 filas).
- ✅ 1 contradicción escrita: papers, en qué difieren y una hipótesis de por qué.
- ✅ Párrafo de consenso y disenso.
- ✅ Audit log L1 con tus dos tasas.
→ Mañana (S03) formulan el problema contra este mapa. La contradicción es candidata a gap o a supuesto que problematizar.
Advertencia
Si vas atrasado: primero cierra el audit log del L1, después el mapa con lo que tengas. Mejor 10 papers verificados que 50 alucinados.
Cierre
Lo que se llevan de S02
Conceptual:
- Diana de 4 capas y pirámide de evidencia: qué tipo de paper sirve para qué.
- Dos presas de la IA: la cita fantasma (no existe) y la cita infiel (existe y no dice eso).
- Lectura en tres pasadas y ficha activa.
Operativo:
- Evidence Map v0 de su tema con 15–25 papers verificados.
- 1 contradicción entre papers, escrita.
- Audit log L1 con sus dos tasas.
Crítico (citables):
- Elicit recupera 39,5 % de lo relevante (Lau et al., 2025): nunca como único buscador.
- GPT-4 acierta cerca del 80 % en el tamizaje (Khraisha et al., 2024): sirve de segundo revisor.
- >30 % de citas inventadas en 2023 (Buchanan et al., 2024). En 2026, enlaces válidos con contenido que no coincide (Onweller et al., 2026). Se verifica la existencia y el contenido.
Pregunta de cierre
De los papers que pasaron tu Lab L1 hoy, ¿cuáles dialogan entre sí y cuáles se contradicen? Mañana formulamos tu problema en esa grieta.
Próximo · S03 (mié 11/11) · U2 Problema de investigación
Mañana formulamos el problema contra su Evidence Map.
- El iceberg del problema: de la situación al problema investigable.
- ARV y DAG provisional.
- La IA critica su pregunta usando sus papers, no papers nuevos.
- Pregunta v2, con el modo declarado: llenar un gap o cuestionar un supuesto.
Importante
Pre-trabajo para S03:
- 🎧 Podcast de U2 (NotebookLM).
- 🛠 Lab L2 · Triangulación aumentada (asincrónico, ~60 min): la misma búsqueda en dos herramientas y comparan qué coincide. Guía del lab.
- 🗺 Evidence Map v0 y la contradicción, a mano.
Consejo
Lecturas mínimas (esta noche):
- (Page et al., 2021): checklist y diagrama (4 págs). Ficha:
Page2021.md. - (Buchanan et al., 2024): el experimento (3 págs). Ficha:
BuchananHillShapoval2024.md. - (Onweller et al., 2026): la cita infiel. Ficha:
Onweller2026CitedNotVerified.md.
📎 Apéndice · respaldo y lectura asincrónica
Láminas que no caben en las 4 horas. Sirven para estudiar en casa o para responder una pregunta en clase.
📎 Respaldo · El peer review · lógica, pasos y tiempos (lectura asincrónica)
El peer review es la columna vertebral de la “literatura científica”. No garantiza verdad — garantiza escrutinio público independiente. Saber cómo funciona te dice qué peso darle a cada paper.
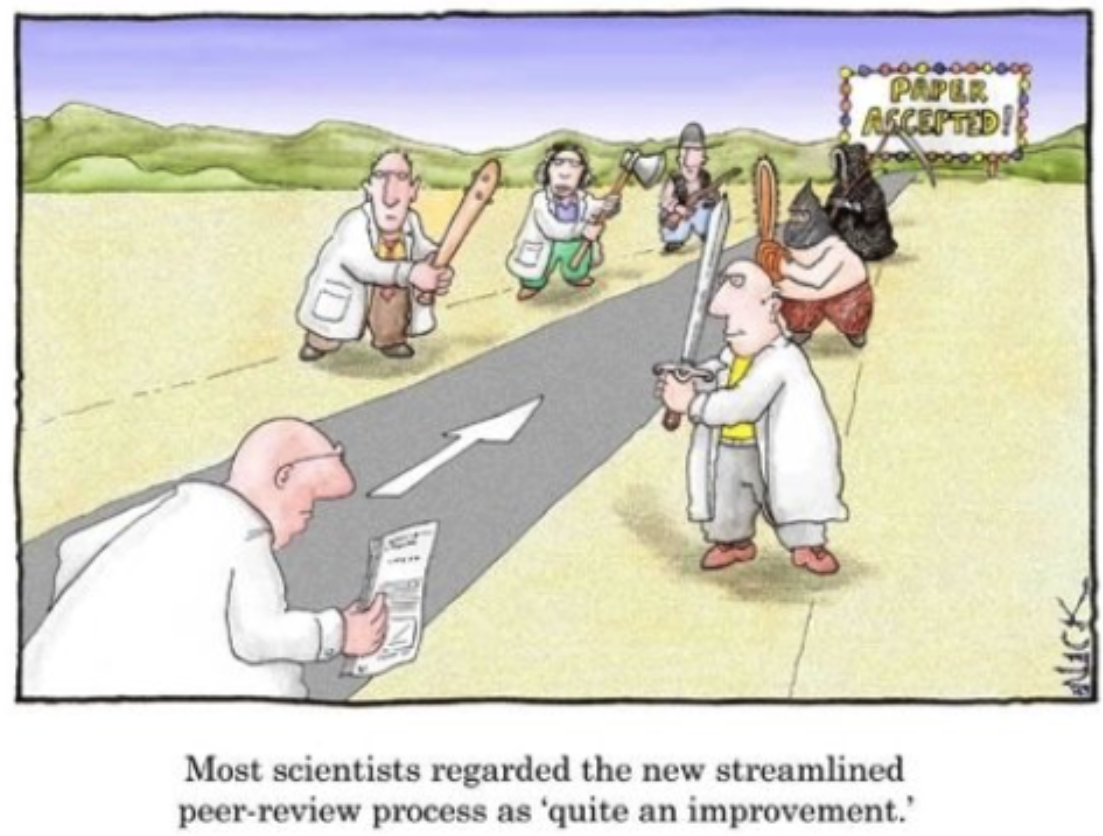
“Most scientists regarded the new streamlined peer-review process as ‘quite an improvement.’” — Sidney Harris.
Qué SÍ cuenta como literatura científica:
- ✅ Journals indexados (Scopus · WoS · EconLit)
- ✅ Working papers serios (NBER · CEDE · IZA · WB · CAF)
- ✅ Libros con peer review (univ. press · Routledge)
- ⚠️ Blogs · podcasts · prensa → solo contexto
- ❌ Redes sociales · ChatGPT como fuente
Los 5 pasos del peer review (cada uno con su tiempo típico):
Consejo
Total submission → impreso: 1.5 a 4 años en economía. Por eso muchos campos circulan working papers primero — la literatura “live” de la frontera (siguiente slide).
📎 Respaldo · Tiempos de aceptación · la evidencia empírica (lectura asincrónica)
¿Por qué importa? Saber cuánto tarda un paper te dice cuánta literatura peer-reviewed tenés realmente disponible sobre un tema reciente vs. cuánto debés complementar con working papers.
| Tipo de outlet | Submit → publicación |
|---|---|
| Top-5 econ AER · QJE · JPE · REStud · ECMA |
2–4 años |
| Field journals JDE · JoLE · JPubE · JHE · JHR |
12–24 meses |
| Health / policy BMJ · Lancet · HE · World Dev |
6–12 meses |
| Working papers NBER · CEDE · IZA · SSRN · CAF |
⚡ inmediato |
Consejo
Card & DellaVigna (2013, JEL) “Nine Facts about Top Journals in Economics” · Ellison (2002, JPE) “The Slowdown of the Economics Publishing Process”.
Hechos clave:
- Desk-reject rate top-5: ~50% (no llegan a pares).
- De los enviados a pares, ~80% terminan rechazados.
- Ellison (2002): mediana submit-to-publish en top-5 subió de <1 año (1970s) a >2 años (2000s).
- Card-DellaVigna (2013): mediana 2.4 años desde primera submission en AER.
Advertencia
Implicación operativa para tu revisión:
- Tema caliente (post-2023) → working papers son la fuente principal · peer-reviewed apenas asoma.
- Tema maduro (pre-2020) → ya hay peer-reviewed sólido · WPs se vuelven historia.
- Estrategia: WPs para frontera + peer-reviewed para fundamento causal.
📎 Respaldo · ⑦ Opinión / grey · World Bank WDR 2020 (lectura asincrónica)
Subiendo la pirámide · de menor a mayor rigor causal. Empezamos por la base: opinión + grey literature. Útil para contexto, pesa poco causalmente.
Año: 2020
Tipo: Flagship report (no peer review)
Descargas: 1M+
- 📚 Síntesis de literatura peer-reviewed previa · NO genera evidencia causal nueva.
- 🏛 Producto institucional con sesgo del organismo emisor.
- 💬 Útil para contexto y cifras descriptivas · cifras causales remiten a papers.
📖 Ver resumen oficial (original en inglés)
"Global value chains (GVCs) powered the surge of international trade after 1990 and now account for almost half of all trade. This shift enabled an unprecedented economic convergence: poor countries grew rapidly and began to catch up with richer countries. Since the 2008 global financial crisis, however, the growth of trade has been sluggish and the expansion of GVCs has stalled. Meanwhile, serious threats have emerged to the model of trade-led growth. New technologies could draw production closer to the consumer and reduce the demand for labor. And trade conflicts among large countries could lead to a retrenchment or a segmentation of GVCs. WDR 2020 examines whether there is still a path to development through GVCs and trade."
World Bank (2020) · World Development Report 2020: Trading for Development in the Age of Global Value Chains · Washington, DC: World Bank · doi.org/10.1596/978-1-4648-1457-0
📎 Respaldo · ⑥ Estudio de caso · Klein, Crawford & Alchian 1978 (lectura asincrónica)
Año: 1978
Revista: J. Law & Econ. 21(2) · 297–326
Citas: 7,500+
- 🏭 Un solo caso histórico: GM compra Fisher Body por hold-up.
- 📜 Fundacional para teoría de la firma (junto a Coase · Williamson).
- ⚖️ Análisis cualitativo riguroso, no estadístico.
📖 Ver abstract completo (original en inglés)
"This paper attempts to explain the kinds of contractual arrangements used to organize economic activity. The presence of appropriable quasi-rents creates the potential for post-contractual opportunistic behavior. Such behavior would dissipate the rents and make it difficult to write enforceable contracts. The paper examines the conditions under which transaction costs of organizing economic activities through market exchanges create incentives for vertical integration. The General Motors–Fisher Body case (1919–1926) is presented as an example of how the threat of opportunistic recontracting can lead to vertical integration when appropriable quasi-rents from specific assets are very large."
Klein, Crawford & Alchian (1978) · Journal of Law & Economics 21(2):297–326 · JSTOR 725234
📎 Respaldo · ⑤ Corte transversal · IV · AJR 2001 (lectura asincrónica)
Año: 2001
Revista: AER 91(5) · 1369–1401
Citas: 14,000+
- 🌐 Cross-section de ~80 ex-colonias.
- 🩺 Mortalidad de colonizadores como instrumento (variación exógena).
- 🏛 Instituciones extractivas vs inclusivas → diferencia ~7× en PIB pc.
📖 Ver abstract completo (original en inglés)
"We exploit differences in the mortality rates faced by European colonialists to estimate the effect of institutions on economic performance. Our argument is that Europeans adopted very different colonization policies in different colonies, with different associated institutions. The choice of colonization strategy was, at least in part, determined by whether Europeans could settle in the colony. In places where Europeans faced high mortality rates, they could not settle and were more likely to set up extractive institutions. These early institutions persisted to the present. We exploit differences in European mortality rates as an instrument for current institutions. Our estimates imply that differences in institutions explain three-quarters of the income gap between Nigeria and Chile. Once the effect of institutions is controlled for, countries in Africa or those farther away from the equator do not have lower incomes."
Acemoglu, Johnson & Robinson (2001) · American Economic Review 91(5):1369–1401 · DOI 10.1257/aer.91.5.1369
📎 Respaldo · ④ Control · DiD · Card & Krueger 1994 (lectura asincrónica)
Año: 1994
Revista: AER 84(4) · 772–793
Citas: 7,000+
- 🍔 410 restaurantes de fast-food (NJ tratado · PA control).
- 📉 Empleo NO cayó con el aumento del mínimo.
- 🔬 Inauguró la credibility revolution en econometría aplicada.
📖 Ver abstract completo (original en inglés)
"On April 1, 1992, New Jersey's minimum wage rose from $4.25 to $5.05 per hour. To evaluate the impact of the law we surveyed 410 fast-food restaurants in New Jersey and eastern Pennsylvania before and after the rise. Comparisons of employment growth at stores in New Jersey and Pennsylvania (where the minimum wage was constant) provide simple estimates of the effect of the higher minimum wage. We also compare employment changes at stores in New Jersey that were initially paying high wages (above $5) to the changes at lower-wage stores. We find no indication that the rise in the minimum wage reduced employment."
Card & Krueger (1994) · American Economic Review 84(4):772–793 · JSTOR 2118030
📎 Respaldo · ③ Longitudinal · Chetty, Hendren & Katz 2016 (lectura asincrónica)
Año: 2016
Revista: AER 106(4) · 855–902
Citas: 2,300+
- 🕰 10–20 años de seguimiento post-tratamiento (datos del IRS).
- 👶 Mudarse antes de los 13 años → +31% ingreso adulto.
- 🎓 Más universidad · menos paternidad temprana.
📖 Ver abstract completo (original en inglés)
"The Moving to Opportunity (MTO) experiment offered randomly selected families housing vouchers to move from high-poverty housing projects to lower-poverty neighborhoods. We present new evidence on the impacts of MTO on children's long-term outcomes using administrative data from tax returns. We find that moving to a lower-poverty neighborhood when young (before age 13) significantly increases college attendance rates and earnings, and reduces single parenthood rates. Moving as an adolescent has slightly negative impacts, perhaps because of disruption effects. The decline in school quality and peer environments instigated by moves in adolescence may explain why the original MTO design did not detect any positive effects on adults' earnings or employment."
Chetty, Hendren & Katz (2016) · American Economic Review 106(4):855–902 · DOI 10.1257/aer.20150572
📎 Respaldo · ② RCT · Miguel & Kremer 2004 (lectura asincrónica)
Año: 2004
Revista: Econometrica 72(1) · 159–217
Citas: 3,500+
- 🎲 Aleatorización en 75 escuelas de Kenya rural (PSDP).
- 📉 Ausentismo −25% en escuelas tratadas.
- 🌐 Spillover sanitario a comunidades vecinas · ignorarlos sesga el ITT.
📖 Ver abstract completo (original en inglés)
"Intestinal helminths—including hookworm, roundworm, whipworm, and schistosomiasis—infect more than one-quarter of the world's population. Studies in which medical treatment is randomized at the individual level potentially doubly underestimate the benefits of treatment, missing externality benefits to the comparison group from reduced disease transmission, and therefore also underestimating benefits for the treatment group. We evaluate a Kenyan project in which school-based mass treatment with deworming drugs was randomly phased into schools, rather than to individuals, allowing estimation of overall program effects. The program reduced school absenteeism in treatment schools by at least one-quarter. Health externalities reduced absenteeism by about as much among untreated school-age children as among treated ones."
Miguel & Kremer (2004) · Econometrica 72(1):159–217 · DOI 10.1111/j.1468-0262.2004.00481.x
📎 Respaldo · ①a Revisión sistemática · tipos según propósito (lectura asincrónica)
Antes del meta-análisis, hay 5 tipos de revisión sistemática. Cada uno responde a una pregunta distinta. Elegir el correcto = ahorrar meses.
Año: 2009
Revista: Health Info Libr J 26(2) · 91–108
Citas: 9,000+
| Tipo | Definición · cuándo usar | Output | Ejemplo canónico |
|---|---|---|---|
| Sistemática | PRISMA exhaustiva · efectos causales con múltiples RCTs/QEs | Síntesis replicable | Snilstveit et al. 2015 · 3ie SR "Interventions for improving learning outcomes in low- and middle-income countries" |
| Scoping | Mapeo del campo · tema emergente sin literatura madura | Mapa de literatura | Banerjee, Niehaus & Suri 2019 · Annu. Rev. Econ. "Universal Basic Income in the Developing World" |
| Narrativa | Argumento crítico · estado del arte para tesis | Ensayo crítico | Card 1999 · Handbook of Labor Econ. "The Causal Effect of Education on Earnings" |
| Rapid | PRISMA-lite · semanas · decisión política urgente | Reporte conciso | Egger, Miguel et al. 2021 · Science Adv. "Falling living standards during COVID-19 in nine LMICs" |
| Living | Continuamente actualizada · campos muy activos | Snapshot vigente | 3ie Evidence Gap Maps · online "Productive inclusion · 700+ studies, en vivo" |
| Meta-análisis | Subconjunto: estadística sobre effect sizes · múltiples RCTs comparables | Effect pooled | Card, Kluve & Weber 2018 · JEEA → ver slide 13/14 |
📖 Ver abstract completo (original en inglés)
"The expansion in the number of review types and methodologies has led to confusion among researchers. This article identifies 14 review types currently used by social and health scientists: critical review, literature review, mapping review/systematic map, meta-analysis, mixed methods review, overview, qualitative systematic review, rapid review, scoping review, state-of-the-art review, systematic review, systematic search and review, systematized review, and umbrella review. Each type is described using the Search · Appraisal · Synthesis · Analysis (SALSA) framework. The article provides guidance for researchers selecting a review type appropriate for their question and resources."
Grant & Booth (2009) · Health Information & Libraries Journal 26(2):91–108 · DOI 10.1111/j.1471-1842.2009.00848.x
📎 Respaldo · ①b Meta-análisis · Card, Kluve & Weber 2018 (lectura asincrónica)
Año: 2018
Revista: JEEA 16(3) · 894–931
Citas: 2,000+
- 📊 207 evaluaciones · 50+ países · misma métrica.
- ⏱ Efecto cambia con el horizonte: ≈0 CP · positivo 2–3 años después.
- 🏗 Capacitación > búsqueda de empleo > subsidios directos.
📖 Ver abstract completo (original en inglés)
"We present a meta-analysis of recent microeconometric evaluations of active labor market policies. Our sample contains 207 studies that yield 857 separate 'program estimates' — estimates of the impact of a particular program on a specific subgroup of participants. In about one-half of these estimates we observe both a short-term impact and at least one medium- or longer-term impact. We classify the estimates by program type, by participant group, and by other key features, and use meta-analytic models to summarize them. We find that average impacts are close to zero in the short run, but become more positive 2–3 years after completion. The time profile of impacts varies by type of program, with larger gains for programs that emphasize human capital accumulation."
Card, Kluve & Weber (2018) · JEEA 16(3):894–931 · DOI 10.1093/jeea/jvx028
📎 Respaldo · PRISMA aplicado · cuento Catatumbo (lectura asincrónica)
Aplicado: la tesis asfalto × violencia × IPM en Catatumbo. De los 805 hits totales → al .bib final de 45 papers usables.
N = 805
(− 401 excluidos)
N = 41
N = 45
Detalle del flujo Catatumbo:
- Identificación (805): WoS 312 · Scopus 248 · OpenAlex 198 · citation chasing 47.
- Tamizado: 318 duplicados eliminados → 487 únicos · 401 excluidos por título/abstract.
- Full-text (86): 41 excluidos · razones documentadas: fuera-tema 24 · idioma 12 · no peer 5.
- Inclusión final: 45 papers al
.bibpara análisis.
Consejo
Cada n del diagrama debe poder reconstruirse por otra persona con la query + fechas + criterios documentados. Eso es transparencia PRISMA: mínimo, no máximo. (Page et al., 2021)
Consejo
Query del cuento (WoS): ("road pavement" OR "transport infrastructure") AND ("armed conflict" OR violence) AND (poverty OR welfare) AND (Colombia OR LATAM) · 2010–2025 · article only.
→ 312 hits + cruce con Scopus + OpenAlex + citation chasing = 805.
Advertencia
Criterios de exclusión declarados arriba: fuera-tema · idioma · no peer-review. Cada estudiante DEBE poder defender esos criterios.
📎 Respaldo · Registros paso a paso · la matriz PRISMA (lectura asincrónica)
PRISMA NO es solo el diagrama de flujo. Es un sistema de registro que documenta cada decisión. 3 logs obligatorios para que tu revisión sea auditable.
Matriz de extracción · plantilla mínima (recomendada):
| Columna | Qué contiene | Catatumbo: ej. Estrada-Vergara 2019 |
|---|---|---|
| ID | citekey | EstradaVergara2019 |
| Autor · año | familia + año | Estrada & Vergara · 2019 |
| Geografía | país · región | Colombia · Catatumbo |
| Diseño | RCT · DiD · IV · etc. | DiD con frontera |
| N · período | tamaño · ventana temporal | 38 mpios · 2012–2018 |
| Tratamiento | variable de interés | km pavimentados |
| Outcome | variable resultado | IPM (multidimensional) |
| Hallazgo clave | magnitud + signo | +5pp IPM · efecto solo si baja violencia |
| Calidad (pirámide) | nivel ①–⑦ | ④ Control DiD |
| Notas / limitaciones | sesgo · validez ext. | pre-trends frágiles · n pequeño |
Consejo
Esta matriz ES el insumo directo del Evidence Map (Sprint 4) · cada fila se convierte en una entrada del mapa de evidencia. Formatos: Excel · Google Sheets · Notion · Quarto table · .csv para importar a R.
Advertencia
Sistemático = replicable. Sin estos 3 logs, tu revisión NO es PRISMA-compliant, da igual qué tan buena sea la literatura. El paso a paso documentado vale más que la elegancia.
📎 Respaldo · Prompt · extraer la matriz PRISMA con IA (lectura asincrónica)
El cuello de botella es leer y extraer 45 papers. Con un prompt bien diseñado, la IA hace la extracción inicial · vos verificás. Reducís 80% del tiempo · NO el 100%.
Prompt listo · copiá-pegá-adaptá:
[ROL]
Sos asistente de investigación en economía aplicada,
trabajando en una revisión sistemática PRISMA.

[TAREA]
Te paso 1 paper (PDF o texto). Extraé los datos
para una fila de mi matriz de extracción.

[OUTPUT FORMATO Markdown]
| Campo            | Valor                  | Confianza |
|------------------|------------------------|-----------|
| ID (citekey)     | AutorAño               | [alta/media/baja] |
| Autor · año      | ...                    | ... |
| Geografía        | país · región          | ... |
| Diseño           | RCT · DiD · IV · etc.  | ... |
| N · período      | tamaño · ventana       | ... |
| Tratamiento      | variable de interés    | ... |
| Outcome          | variable resultado     | ... |
| Hallazgo clave   | magnitud + signo       | ... |
| Calidad pirámide | nivel ①–⑦              | ... |
| Limitaciones    | sesgo · validez ext.   | ... |

[REGLAS DURAS]
1. Si NO encontrás un dato en el paper, escribí
   [MISSING] · NO inventes.
2. Para "Confianza" usá: alta (texto explícito),
   media (inferido de tablas/figuras), baja
   (mi interpretación de lo que dice el autor).
3. Citá número de página entre paréntesis para
   los campos de Confianza alta.
4. Para "Calidad pirámide" usá EXACTAMENTE estos
   niveles: ① Meta · ② RCT · ③ Longitudinal ·
   ④ Control/DiD · ⑤ Cross-section · ⑥ Caso ·
   ⑦ Opinión/grey.
5. Si el paper es un working paper, anotalo en
   "Limitaciones" (no es peer-reviewed).
Workflow recomendado · batch de 10 papers:
| Paso | Acción | Tiempo |
|---|---|---|
| 1 | Subí PDFs a NotebookLM o Claude Projects | 5 min |
| 2 | Pegá el prompt · 1 paper por vez | 2 min/paper |
| 3 | Copiá output Markdown a tu matriz (Sheets/Notion) | 1 min/paper |
| 4 | Verificá los campos [MISSING] + los de Confianza baja |
5–10 min/paper |
| 5 | Spot-check 2–3 random campos de alta confianza | 5 min |
Advertencia
Reglas operativas:
- Verificá siempre N y la cifra del efecto (Confianza alta sin verificar = el peor sesgo).
- NO copies sin leer · el prompt acelera, no reemplaza.
- Si Confianza baja en >3 campos: re-leer el paper completo, no confiar en la IA.
Consejo
Batch mode (avanzado): subí 10 PDFs a NotebookLM · pedile “para CADA paper de mis fuentes, dame la fila completa de la matriz, separadas por ---”. Reduce iteraciones.
Consejo
Conexión Sprint 4: las filas que salgan de este prompt son las filas de tu Evidence Map. La matriz PRISMA y el Evidence Map son el mismo documento en distintos momentos del pipeline.
📎 Respaldo · ¿Por qué alucina? · 3 mecanismos (lectura asincrónica)
No es un bug · es la naturaleza del LLM. Entender el mecanismo te dice cómo mitigarlo.
📎 Respaldo · 5 recomendaciones para evitar alucinaciones (lectura asincrónica)
Consejo
Regla operativa: combina ② RAG + ③ CoVe + ⑤ verificación humana. Las 5 NO son alternativas — son una cadena que se acumula.
📎 Respaldo · ¿Por qué cambió leer en la era IA? (lectura asincrónica)
No estamos leyendo más · estamos leyendo distinto. El volumen de papers se duplica cada 17 años (Bornmann et al., 2021). Imposible leer todo · obligatorio decidir cómo.
- Leer 1 paper completo en 1–4 hrs
- Highlight + notas en papel/PDF
- Resumir manual en Word/Notion
- Sintetizar mentalmente
- Cuello de botella: tiempo de lectura
- Skim asistido en 5–10 min
- Q&A directo al paper
- Resumen + tabla auto-extraída
- Cross-paper preguntas (NotebookLM)
- Nuevo cuello: verificación + retención
Advertencia
El riesgo de la era IA: “leer delegado sin entender”. El skim asistido te da el qué; sin pasar por el cómo no podés debatir el paper en defensa de tesis.
Consejo
Regla pedagógica del Sprint 3: la IA es para acelerar lectura · NO para reemplazarla. Cada paper que entre a tu marco teórico (U5) debe pasar por lectura activa + ficha escrita por vos.
La pregunta del Sprint: ¿cómo leo 25 papers asistido con IA sin perder rigor crítico ni retención?
📎 Respaldo · Profundidad de lectura × capa de diana (lectura asincrónica)
Doble conexión: Sprint 1 (JC 4/13 · diana 4 capas) + JC 2/7 anterior (Keshav 3-pass). Recordá: la diana ordena papers por especificidad y Keshav ordena lecturas por profundidad — ahora cruzamos los dos ejes. La profundidad con que leés cada paper depende de DÓNDE encaja en tu diana.
Recap diana ①→④:
Mapeo capa diana → pass Keshav → tiempo por paper:
| Capa | Pass Keshav | Tiempo / paper | Por qué |
|---|---|---|---|
| ① Problemas | Pass 3 | 4–5 h | Define el gap específico de tu tesis · necesitás defenderlo paper-by-paper en el comité. |
| ② Objetivos | Pass 2–3 | 1–4 h | Papers seminales que estructuran tu marco · lo que TODOS citan. |
| ③ Metodología | Pass 2 | 30–60 min | Extraés el método aplicable (DiD · IV · DAG) sin necesitar entender todo el contexto. |
| ④ Estilo | Pass 1 | 5–10 min | Leés como modelo de escritura · escaneás cómo presentan, no qué dicen. |
Consejo
Conexión con JC 5/7 (ficha de lectura): la sección 12 · Status de tu ficha registra qué pass alcanzaste · una ficha “pass-1” vale lo mismo que una “pass-3” si está bien clasificada por capa.
Advertencia
Trampa común: intentar pass 3 en TODOS los papers → te quedás sin tiempo para los de capa ①②. Especificidad ≠ cantidad — leé profundo solo donde la diana lo exige.
📎 Respaldo · Del árbol al bosque · visión integral (lectura asincrónica)
Las fichas son árboles. La revisión es el bosque. 25 fichas perfectas sin conexiones = una pila de árboles. Marco teórico (U5) requiere ver el bosque.
🌳🌲🌳
Advertencia
Trampa: parar en las fichas. Sin la vista bosque, no podés: justificar gap · hacer síntesis temática · defender por qué TU pregunta es la siguiente.
4 herramientas para construir vista-bosque:
[[citekey]] genera grafo automático · open source.Consejo
Workflow recomendado: fichas Markdown con [[links]] → Obsidian para vista grafo → NotebookLM Mind Map para skim → Evidence Map (Sprint 4) como producto formal.
📎 Respaldo · RAG con NotebookLM · estructurar para que funcione (lectura asincrónica)
NotebookLM es la herramienta IA más útil de tu Sprint 3. Pero solo si lo organizás bien. Las 4 reglas + cómo subir las fichas como fuentes adicionales.
Arquitectura recomendada:
Prompts que sí funcionan en NotebookLM:
✅ "Hacé una tabla con: paper, diseño,
   país, hallazgo principal · sólo
   desde mis fuentes."

✅ "¿Qué autores se contradicen sobre
   el efecto de [X]? Cita página."

✅ "Identificá los 3 papers que más
   se citan entre sí. ¿Por qué?"

❌ "¿Cuál es el mejor método para X?"
   (NotebookLM no opina · responde
    desde fuentes)

❌ "Dame 10 papers sobre X."
   (No genera lista nueva · sólo
    trabaja sobre las fuentes que
    le diste).
Advertencia
Limitaciones: máximo 50 fuentes por notebook · no podés editar el contenido de las fuentes desde NotebookLM · sin colaboración multi-usuario.
📎 Respaldo · Gestores bibliográficos · Zotero · Mendeley · BibTeX (lectura asincrónica)
El puente entre PDFs · fichas · escritura. Sin gestor: 6 meses metido en archivos sueltos. Con gestor: tu .bib y tus PDFs cantan juntos.
| Gestor | ✅ Pros | ⚠️ Contras | Integración IA | $ |
|---|---|---|---|---|
| Zotero (recomendado) | OSS · plugin better-bibtex sync .bib auto · web import · grupos | UI menos pulida que Mendeley | Plugins: GPT, Zotero Assistant, Scite | Gratis |
| Mendeley | Reader integrado · sync cross-device · AI summarization (paid) | Elsevier · históricamente cerrado · futuro incierto | Mendeley AI · ScopusAI plugin | Freemium |
| EndNote | Estándar institucional · CWYW Word plugin | Paid · proprietary · BibTeX export incompleto | Limitada | ~$300 |
| BibTeX puro (.bib) | Texto plano · git-friendly · directo Quarto/LaTeX | Requiere mantenimiento manual | Compatible con todo | Gratis |
Workflow integrado recomendado (MAE):
🌐 Web (paper) ──Zotero connector──▶ Zotero library
                                       │
                          better-bibtex export auto
                                       ▼
                                  📄 references.bib
                                       │
                                       ▼
                  ──────────┬──────────┴──────────┐
                  ▼         ▼                     ▼
          📓 Quarto    🤖 NotebookLM        ✍️ tu ficha .md
          [@cite]     (sube .bib + PDFs)    (citekey=Zotero key)
Consejo
Setup mínimo (15 min, 1 vez):
- Instala Zotero (gratis · zotero.org).
- Instala plugin better-bibtex (configura citekeys automáticos formato
AutorAño). - Configura auto-export a
~/Documents/references.bib. - En Quarto:
bibliography: references.bibapunta al archivo. - Para cada paper nuevo: 1-click Zotero → entra a tu .bib → cita
[@AutorAño].
Advertencia
No mezcles gestores. Elegí 1 y consolidá ahí TODO. Sincronizar entre Zotero + Mendeley + EndNote = dolor crónico.
📎 Respaldo · Herramientas visuales · ejemplo Litmaps Catatumbo (lectura asincrónica)
El reemplazo accesible de bibliometrix: apps web que dibujan tu corpus sin escribir código R. Cada una te enseña algo distinto sobre el bosque.
5 alternativas a bibliometrix · ¿qué pregunta responde cada una?
Consejo
Para 50 min de Sprint 4: Litmaps + NotebookLM Mind Map. Combinás vista de citas (Litmaps) + vista temática (NotebookLM) en 10 min.
🎯 Ejemplo · Catatumbo en Litmaps:
Advertencia
Litmaps Spark (su feature de descubrimiento automático) sugiere papers que vos no buscaste pero que otros relacionados sí leen. Útil para encontrar el ⑤ contradicción viva.
Consejo
Costo: Litmaps gratis hasta 3 maps · paid después (~$10/mes para tesis). Alternativa OSS: Connected Papers + Inciteful combinados.
Referencias
EC0744 · Seminario de Investigación Aplicada Universidad EAFIT · Escuela de Finanzas, Economía y Gobierno 2026-2