%%{init: {'flowchart': {'htmlLabels': false, 'curve': 'basis'}, 'themeVariables': {'fontSize': '22px', 'fontFamily': 'sans-serif'}}}%%
flowchart TB
    A[Presencia armada] -->|costos tx| B[Migración]
    A --> C[Inversión local]
    C --> D[Empleo]
    B --> E[IPM sube]
    D --> E
De situación problemática a problema de investigación
El filtro ARV, la pregunta correcta y prompt engineering como competencia
Juan Carlos Muñoz-Mora, PhD
Universidad EAFIT · Escuela de Finanzas, Economía y Gobierno
12 de mayo de 2026
Bienvenidos
Unidad 2 — Problema de investigación
Sesión 2 (mar 12/05 · 4h) + Sesión 3 parte 1 (mié 13/05 · 1.5h)
Nota
Hoy: Martes 12 de mayo · 18:00–22:00 · Aula 38-303 Pregunta guía: ¿Cómo paso de una intuición a una pregunta de investigación que sea identificable, relevante y abordable?
Lo que entregan al final de S3:
- Pregunta de investigación clara
- Filtro ARV diligenciado
- Estadística descriptiva mínima
- Declaración AIAS de uso de IA
🌉 Puente · de S01 a S02
S01 nos dio el marco. S02 lo pone a trabajar sobre un problema concreto.
📚 Lo que trajimos de S01
- Método económico (Mill → Popper → Friedman) y los 5 rasgos de la investigación económica.
- Bonnen 1986: investigación disciplinaria · temática · basada en problemas.
- Ciclo de 7 etapas + creatividad como margen.
- Marco IA²: Tú eres el investigador. La IA es tu palanca.
- AIAS 5 modos + audit log obligatorio.
- Belmont 1979 + política de uso de IA firmada.
🎯 Lo que hacemos hoy
- Pasar de investigación basada en problemas (Bonnen) a problema investigable (Ethridge).
- Operacionalizar la etapa 1 del ciclo — formular el problema con rigor.
- Activar AIAS-3 (Collaboration) sobre un caso real: tu propio problema.
- Estrenar el audit log sobre prompts del Sprint 3.
- Producir 4 artefactos que alimentan Hito H1 (cierra en U3).
🔑 La idea estructural de hoy: cada sprint convierte un concepto del marco S01 en un artefacto operativo de tu problema de investigación.
🌉 Puente · qué de S01 vive en cada sprint de hoy
| Sprint | Concepto de S01 que opera hoy | Cómo se materializa | Modo AIAS |
|---|---|---|---|
| 1 | Bonnen · investigación basada en problemas + ciclo etapa 1 | Iceberg 4 capas: tema → situación → mecanismos → problema investigable | 2 |
| 2 | Método económico (causal, no descriptivo) + ciclo etapa 2 | ARV (3-3-3) → DAG provisional con reglas Pearl | 2 |
| 3 | Marco IA² + AIAS + audit log de S01 | Prompt-ready de 7 secciones + caza de alucinaciones | 3 |
| 4 | 5 tipologías de pregunta + creatividad como margen | Pregunta v1 → v2 con verbo·objeto·población·período·método | 2 |
Importante
Regla del puente: cuando JC diga “recuerden de S01…”, busquen aquí. Si un concepto de S01 no aparece en esta tabla, es porque vuelve en U3-U7 — no se perdió.
Cómo trabajamos hoy — los 4 sprints
Nota
Regla del aula: cada sprint mezcla presentación (JC) + actividad activa (hands-on, no lectura pasiva) + descanso. La actividad siempre produce un artefacto que pega en su carpeta de unidad.
| Sprint | Tema | JC | 🔧 Actividad | ☕ Descanso | Hora fin |
|---|---|---|---|---|---|
| 1 | Iceberg del problema | 35 | 15 | 20 | 19:10 |
| 2 | ARV → DAG provisional | 15 | 35 | 10 | 20:10 |
| 3 | Datos + IA crítica | 35 | 15 | 10 | 21:10 |
| 4 | Pregunta v1 → v2 | — | 30 | — | 21:40 |
Consejo
Lecturas hoy: (Korinek, 2023) cap. 3 + (Ludwig & Mullainathan, 2024) (QJE) + ficha Korinek2023.md
Advertencia
4 artefactos al final: iceberg lleno · ARV+DAG · prompt+audit log · pregunta v2.
Sprint 1 · Iceberg del problema
18:00 → 19:10 · ¿Por qué algunos temas son investigación y otros son periodismo?
⏱️ Bloque35 JC · 15 Act · 20 Desc
🎯 MetaDistinguir tema / situación / mecanismos / problema
📦 ArtefactoPlantilla iceberg con tu tema (capas 1+2)
🧪 CheckpointFrase de fricción empírica
Nota
🌉 De S01: Bonnen 1986 — investigación basada en problemas + etapa 1 del ciclo de 7 etapas. Hoy le damos estructura formal (iceberg) y un caso propio.
La metáfora · el problema vive bajo el agua
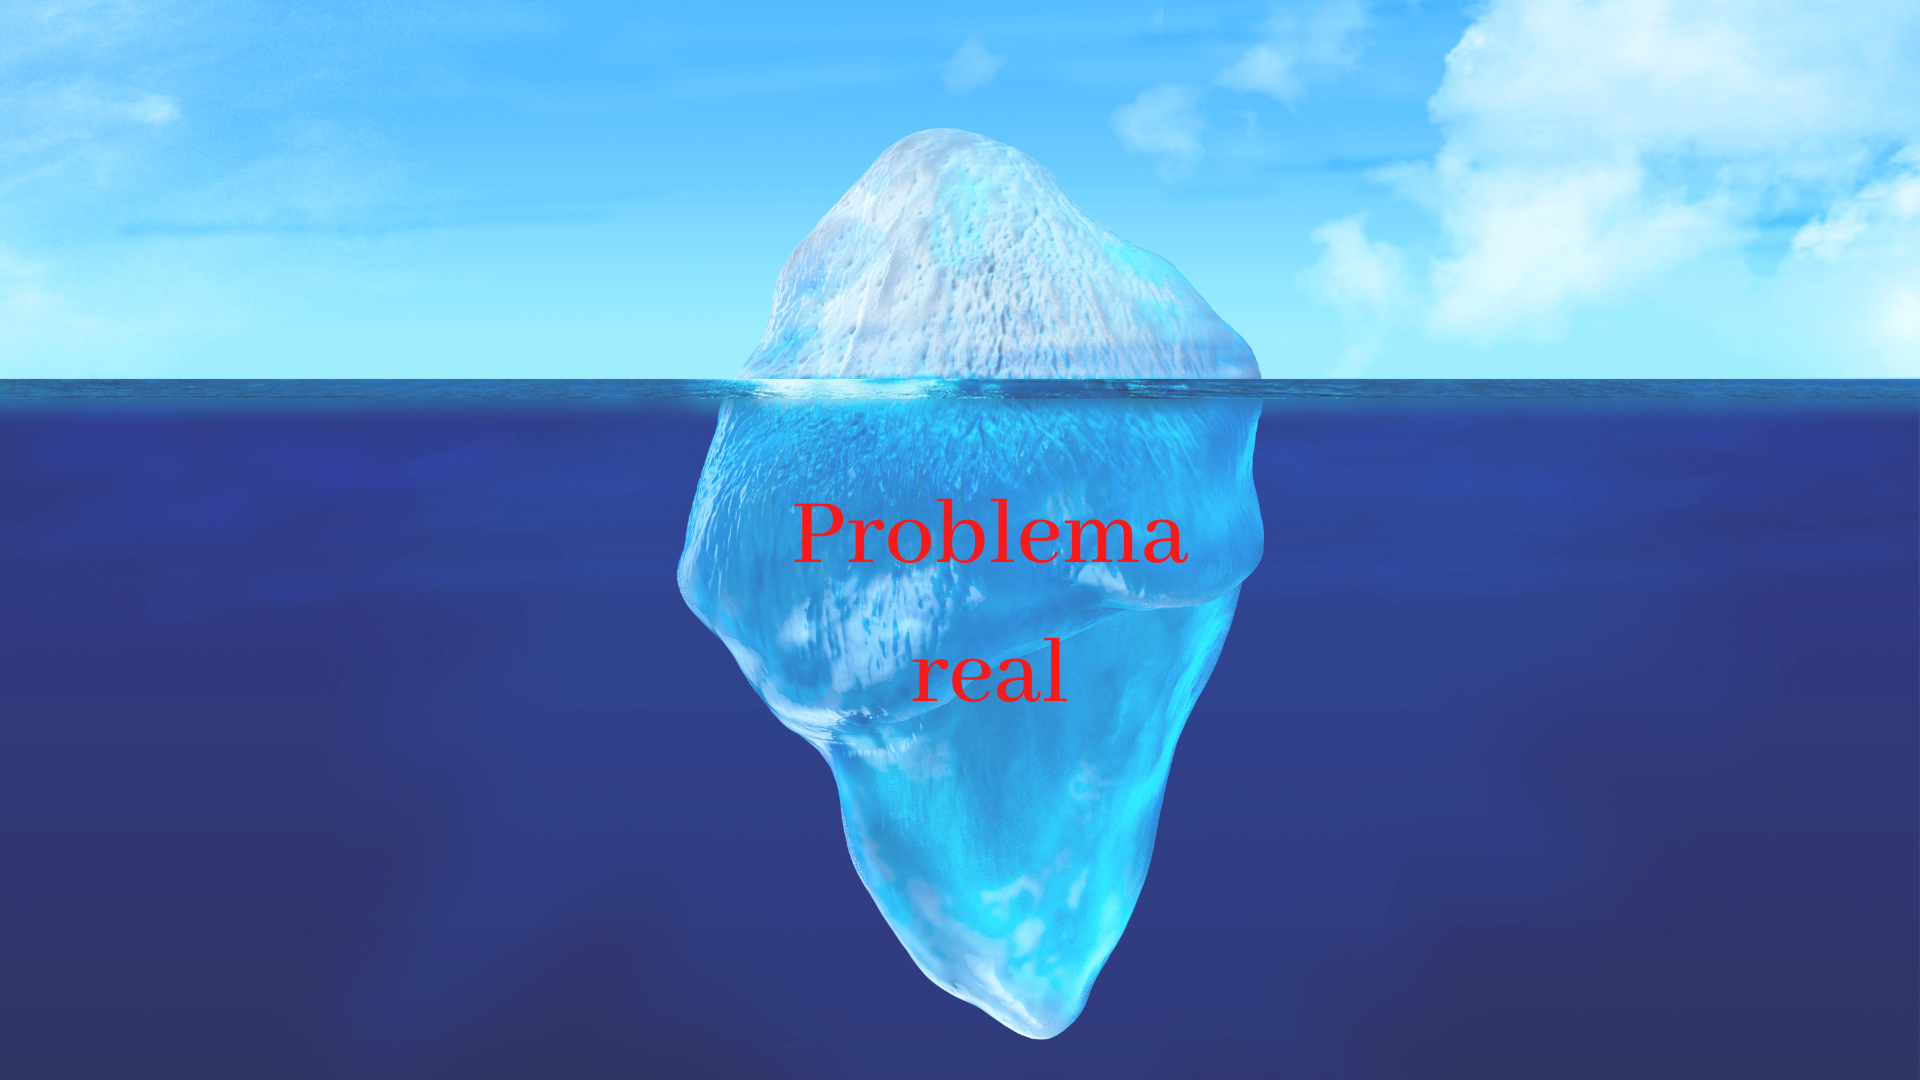
Lo que vemos es solo la punta.
El problema real — sus causas, mecanismos, actores — vive debajo de la línea de flotación.
Consejo
Esta metáfora aparece en systems thinking (Senge), Long & Long (sociología) y, formalmente para investigación aplicada, en (Ethridge, 2004) cap. 5.
La triada clásica
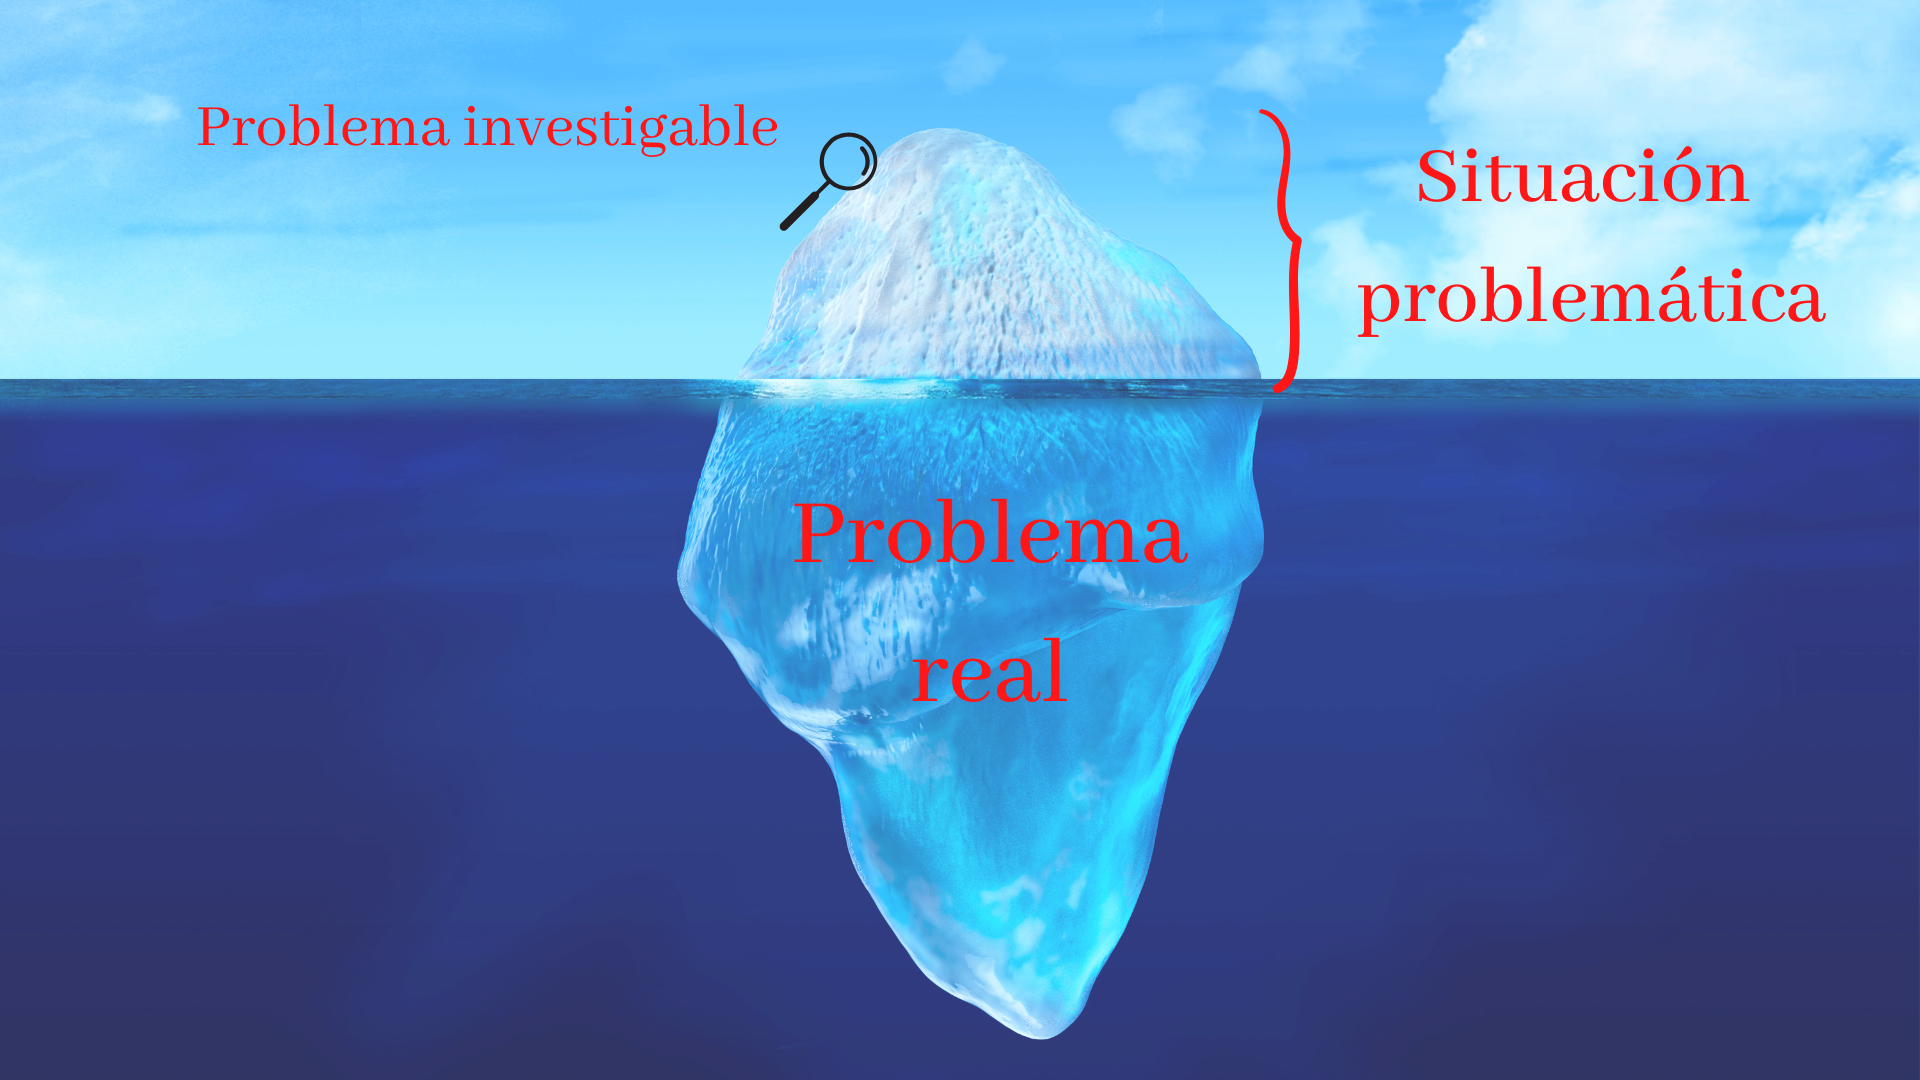
Tres niveles, uno solo es investigable:
🔍 Problema investigable (la punta)
La pieza acotada que sí podés responder con tus métodos, datos y tiempo.
🌊 Situación problemática (la zona de fricción)
Donde hay tensión empírica visible (datos que no encajan, política que no funciona donde debería).
🧊 Problema real (la masa sumergida)
El fenómeno del mundo — gran alcance, muchas dimensiones. No es investigable en un solo proyecto.
“Las situaciones problemáticas no son investigables dentro de un proyecto de investigación individual; sus componentes específicos sí lo son cuando se dividen en partes confinadas en alcance y complejidad, y apoyan objetivos alcanzables dentro de las restricciones de recursos.” — (Ethridge, 2004) cap. 5.
(Ethridge, 2004) · (Bairagi & Munot, 2019) · (Hernández-Sampieri, 2010) llegan al mismo marco desde economía aplicada, ingeniería y sociología educativa — convergencia internacional.
La triada · dos ejemplos vivos
🌎 Migración venezolana → Colombia
🧊 Problema real La crisis migratoria de Venezuela: ≈ 8M de personas desplazadas desde 2015, integración económica multi-país.
🌊 Situación problemática En Colombia, 2.8M de venezolanos con Permiso de Protección Temporal desde 2021. ¿Compiten con trabajadores informales locales? ¿Bajan salarios? ¿Aumentan productividad?
🔍 Problema investigable “¿Efecto del PPT 2021 sobre la informalidad laboral de hogares colombianos receptores en municipios fronterizos vs no fronterizos (GEIH 2019–24), mediante DiD?”
🤖 IA generativa y mercados laborales
🧊 Problema real Cambio tecnológico y empleo — desde Engels hasta hoy. Macro-tendencia que afecta todas las economías.
🌊 Situación problemática GPT-4 expone ≥ 10% de tareas en el 80% de los trabajadores de EE.UU. (Eloundou et al., 2024); +14% productividad en call centers (Brynjolfsson et al., 2025). ¿Aplica en LATAM con datos en español y mercados más informales?
🔍 Problema investigable “¿Efecto de la exposición a IA (Eloundou index, traducido a CIIU) sobre salarios formales en ocupaciones colombianas 2022–25 (GEIH), comparando ocupaciones de alta vs baja exposición mediante shift-share IV?”
Patrón: en ambos casos la 🧊 capa real es enorme e inabordable; la 🌊 situación problemática ya está acotada por datos disponibles; la 🔍 pregunta investigable añade población · período · método · contraste.
El iceberg del problema de investigación
🌊Capa 1 · Tema visible
la noticia, el titular, la inquietud
🏔️Capa 2 · Situación problemática
datos, magnitudes, fricción empírica
~ línea de flotación ~
🧊Capa 3 · Mecanismos — ARV
actores, relaciones, variables
🔬Capa 4 · Problema investigable
pregunta acotada, identificable, abordable
Lo que se ve arriba son síntomas. La investigación vive debajo de la línea de flotación.
- Capa 1–2: lo cuenta el periodismo.
- Capa 3 (ARV): lo cuenta el economista.
- Capa 4: la pregunta que sí se puede responder con tus recursos.
Consejo
Origen del marco: systems thinking (Senge) + tríada situación problemática / problema investigable de (Ethridge, 2004) cap. 5 + checklist operativo de (Bairagi & Munot, 2019) cap. 2.
Ethridge ↔︎ el iceberg
| Triada Ethridge 2004 | Iceberg (4 capas) | Quién la habita |
|---|---|---|
| 🌍 Situación real | Contexto que envuelve todo | Realidad / periodismo |
| 🌊 — | Capa 1 · Tema visible | Titular / inquietud |
| ⚡ Situación problemática | Capa 2 · Fricción empírica | Periodismo de datos |
| — | Capa 3 · Mecanismos (ARV) | El economista |
| 🔬 Problema investigable | Capa 4 · Pregunta acotada | Investigador |
Lo que el iceberg agrega a Ethridge:
- Capa 1 (tema visible) — explicita el “punto de entrada” emocional / mediático que muchos confunden con investigación.
- Capa 3 (ARV) — operacionaliza el paso de Capa 2 a 4 con una herramienta concreta: actores, relaciones, variables.
Consejo
El salto crítico está entre 🏔️ Capa 2 y 🔬 Capa 4. Sin Capa 3, te brincas el mecanismo y produces preguntas frágiles.
Las 4 capas en un ejemplo: Catatumbo
🌊 Capa 1 — Tema visible
“La pobreza en Colombia.” → Amplio, sin fricción, sin hipótesis testable.
🏔️ Capa 2 — Situación problemática
“En el Catatumbo, el IPM empeoró 2018–2023 mientras el país mejoró.” → Tensión empírica visible.
🧊 Capa 3 — Mecanismos (ARV)
A: hogares, FARC-EP disidencias, productores ilícitos, gobierno municipal. R: presencia armada → costos transacción → migración → IPM. V: hectáreas coca, IPM, victimización, gasto público.
🔬 Capa 4 — Problema investigable
“¿Qué efecto tuvo la presencia de economías ilícitas sobre el IPM del Catatumbo en el período post-acuerdo (2017–2023)?”
La pregunta no nace abstracta — emerge cuando bajas las 4 capas con disciplina.
Lo que NO es problema de investigación
❌ Una opinión disfrazada “¿Por qué el modelo neoliberal fracasó en Colombia?” — asume el resultado.
❌ Una pregunta normativa “¿Debería el Estado subsidiar la educación superior?” — es debate político.
❌ Una pregunta sin fricción empírica “¿Cómo afecta la educación al ingreso?” — Mincer 1974, ya hay 50 años de literatura.
✅ Tensión entre teoría y dato “La teoría de Solow predice convergencia; los Llanos no convergen — ¿por qué?”
✅ Hueco en evidencia local “Los efectos de Familias en Acción están medidos a nivel nacional; ¿qué pasa en municipios PDET?”
✅ Pregunta causal con identificación posible “¿Tuvo efecto la 4G en empleo en municipios cruzados vs no cruzados?” (DiD posible)
Un buen problema empieza donde se acaba la literatura, no donde empieza la opinión.
De problema investigable a pregunta de investigación
Advertencia
Cuidado: el problema investigable (Capa 4 del iceberg) no es todavía una pregunta de investigación. Es el territorio; la pregunta es la coordenada GPS.
Lo que tiene un problema investigable:
- Un fenómeno acotado en alcance y complejidad.
- Una población, lugar y periodo.
- Una intuición causal o descriptiva.
Lo que le falta para ser pregunta:
- 🎯 Verbo de acción medible.
- 📐 Variables operacionalizadas con fuente.
- 🔬 Marco de identificación (causal / descriptivo / exploratorio).
- ⚖️ Contraste explícito (¿comparado contra qué?).
Ejemplo del paso:
Nota
Problema investigable (Catatumbo): “¿Qué efecto tuvo la economía ilícita sobre el IPM del Catatumbo, 2017–2023?”
Consejo
Pregunta de investigación (operativa): “¿Cuál es el efecto promedio del cambio en hectáreas de coca (UNODC) sobre el IPM municipal (DANE) en municipios del Catatumbo entre 2017–2023, comparando municipios con presencia de FARC-EP disidencias vs sin presencia, mediante DiD?”
→ Lo que se añadió: variable + fuente + comparación + método.
Anatomía de una buena pregunta
Una pregunta de investigación tiene 4 elementos visibles:
- Verbo de acción clarito (medir, evaluar, comparar, identificar — NO “explicar” ni “analizar”).
- Objeto específico (la variable o fenómeno).
- Población/contexto delimitado (geografía, tiempo, subgrupo).
- Marco implícito (causal, descriptivo, exploratorio).
Consejo
Plantilla: > ¿Qué [efecto/asociación/diferencia] tiene [tratamiento/variable] sobre [outcome] en [población] durante [período], y bajo qué condiciones se modifica?
Filtro FINER (Hulley et al., Designing Clinical Research, Wolters Kluwer): Feasible · Interesting · Novel · Ethical · Relevant.
Las 8 características de Bairagi
(Bairagi & Munot, 2019) Research Methodology cap. 2 (sec. 2.7) — el checklist operativo que tu pregunta debe pasar antes de salir de Sprint 1:
| # | Característica | Pregunta-control |
|---|---|---|
| 1 | Known fact | ¿La sostiene un hecho ya documentado? |
| 2 | Gap | ¿Identifica una brecha respecto a lo existente? |
| 3 | Appealing | ¿Te interesará en 4 meses? |
| 4 | Exploratory | ¿Se puede investigar con datos? |
| # | Característica | Pregunta-control |
|---|---|---|
| 5 | Noteworthy | ¿Contribuye al subject? |
| 6 | Feasible | ¿Cabe en tu tiempo, datos, skills? |
| 7 | Ethical | ¿No daña a nadie? |
| 8 | Clarity | ¿≤ 2 frases y precisa? |
Consejo
Convergencia: las características 4, 6, 7 son literalmente FINER. Bairagi (ingeniería/ciencias) y Hulley (medicina) llegaron al mismo destino desde campos distintos — eso refuerza la robustez del filtro.
Errores que arruinan tu problem statement
(Bairagi & Munot, 2019) sec. 2.8.2 — los 9 antipatrones más comunes. Si caes en ≥ 2, tu pregunta todavía no es problem statement:
❌ No tener idea exacta de qué hacer (sin pinpointing). ❌ No estar calificado en el subject (skills gap). ❌ No articular por qué el tema importa. ❌ Ignorar disponibilidad de base de datos. ❌ Ignorar restricciones legales/éticas del dominio.
❌ Ignorar restricciones de seguridad (militar, biomédico). ❌ No considerar el costo del proyecto. ❌ Demasiado angosto o demasiado vago. ❌ Tema controversial u overdone.
Advertencia
Reglas duras (sec. 2.8.1.1): un solo problema · ≤ 2 frases · NO sugiere la solución en el statement.
Ejemplo malo citable ((Bairagi & Munot, 2019) sec. 2.8.1.2): “Novel algorithm to improve speed of classification using K-means.” → 3 errores: pre-especifica método, usa “novel” (palabra vacía), usa “algorithm” (limita scope).
Ejemplos de evolución de una pregunta
v1 (estudiante): > “¿Cómo afecta la pandemia a las MIPYME?”
❌ Tema, no pregunta.
v2 (con ARV): > “¿Qué efecto tuvo el confinamiento del 2020 sobre la mortalidad empresarial de MIPYME en Antioquia?”
⚠️ Mejor, pero “efecto” sin método específico.
v3 (con identificación): > “¿Cuál fue el efecto del confinamiento Q2-2020 sobre la tasa de cierre de MIPYME en Antioquia, comparando municipios con/sin restricciones de movilidad mediante DiD?”
✅ Acción, objeto, población, período, método.
v4 (con condicionalidad): > “… y se modifica el efecto según el sector económico (servicios vs manufactura) o el acceso previo a financiamiento formal?”
Caso vivo · IA y mercados laborales
Iceberg completo con literatura 2024–2025: una pregunta abierta hoy mismo en economía aplicada.
🌊 Capa 1 — Titular 2024
“¿La inteligencia artificial generativa va a destruir empleos en Colombia?”
🏔️ Capa 2 — Fricción empírica
- 80% de los trabajadores de EE.UU. tienen ≥10% de sus tareas expuestas a GPT-4 (Eloundou et al., 2024, Science).
- En un call center real, productividad +14% promedio, hasta +34% en los menos experimentados (Brynjolfsson et al., 2025, QJE).
- Pero: “el crecimiento del PIB por IA será modesto y heterogéneo” (Acemoglu, 2025, Economic Policy).
🧊 Capa 3 — Mecanismos (ARV)
- A: trabajadores · empleadores · plataformas (GitHub, Khanmigo) · sindicatos · MinTrabajo.
- R: exposición a IA → ajuste de tareas → cambio en demanda de skills → salarios/desempleo.
- V: Eloundou exposure index, ENPH/GEIH ocupaciones, BACO salarios, productividad sectorial DANE.
🔬 Capa 4 — Pregunta investigable
“¿Cuál es el efecto de la exposición a IA generativa (Eloundou index 2024) sobre el empleo formal y los salarios en ocupaciones colombianas 2022–2025 (GEIH), comparando ocupaciones de alta vs baja exposición mediante shift-share IV?”
Catálogo: 6 problemas vivos en LATAM
🤖 IA y trabajo
Capa 4: ¿Efecto de exposición a GenAI sobre salarios en ocupaciones CO 2022–25 (GEIH × Eloundou index)? (Eloundou et al., 2024), (Brynjolfsson et al., 2025)
🌎 Migración VE → CO
Capa 4: ¿Efecto del Permiso de Protección Temporal sobre informalidad de hogares receptores en áreas con/sin alta presencia previa, 2021–24?
🌱 Sustitución de cultivos
Capa 4: ¿Efecto del PNIS sobre hectáreas de coca y desplazamiento, comparando veredas tratadas vs no tratadas en Tumaco, Catatumbo y Putumayo 2017–24?
⚡ Transición energética
Capa 4: ¿Efecto de la entrada de generación solar a gran escala en La Guajira sobre empleo local formal e informal, 2020–25?
📱 Gig economy
Capa 4: ¿Efecto de trabajar en Rappi/iFood sobre cotización a pensión y permanencia laboral 2019–24 (vs cohorte comparable no-plataforma)?
💸 Educación financiera
Capa 4: ¿Efecto del programa de cuentas de ahorro escolar (Bancolombia/MinEducación) sobre uso de productos formales 5 años después, RDD por edad?
Advertencia
Regla del catálogo: estos son anzuelos, no preguntas listas. Antes de adoptar uno: (1) verifica que la literatura no lo haya respondido (Scopus + Google Scholar últimos 5 años), (2) verifica que los datos existan, (3) baja por tu propio iceberg.
Heilmeier Catechism · 9 preguntas
George Heilmeier (director DARPA, 1975) dejó un test de 9 preguntas que todo comité de propuestas todavía usa hoy. Tu pregunta debe poder responder cada una en ≤ 1 frase, sin jerga (Heilmeier, 1992):
- ¿Qué estás intentando hacer? (sin jerga)
- ¿Cómo se hace hoy? ¿Cuáles son los límites de la práctica actual?
- ¿Qué es nuevo en tu enfoque? ¿Por qué crees que va a funcionar?
- ¿A quién le importa? (stakeholders concretos)
- Si tienes éxito, ¿qué diferencia hace? (impacto)
- ¿Cuáles son los riesgos?
- ¿Cuánto va a costar? (tiempo + dinero + datos)
- ¿Cuánto va a tomar?
- ¿Cuáles son los checkpoints intermedios y finales para verificar éxito?
Consejo
Test rápido: si no puedes responder #1, #4 y #5 en 30 segundos, vuelves al iceberg Capa 2 — no tienes problema todavía.
“Si no puedes explicarlo simple, no lo entiendes lo suficiente.” — Heilmeier, parafraseando a Feynman.
Gap-spotting vs Problematization
(Alvesson & Sandberg, 2011) Academy of Management Review — el debate moderno sobre cómo nacen las preguntas. Hay dos modos, con consecuencias distintas:
🧱 Gap-spotting (modo dominante)
“Encontrar la grieta en la literatura existente y rellenarla con un ladrillo más.”
Cómo se hace: - Leer 30 papers del subcampo. - Detectar la “gap” en discusión / método / contexto. - Adoptar los supuestos del campo y añadir tu marginal.
Resultado: preguntas incrementales, publicables, bajo riesgo, bajo impacto.
Ej.: “Replicar el efecto de educación sobre ingreso en municipios PDET.”
🔄 Problematization
“Cuestionar los supuestos del campo y proponer una pregunta que los desafíe.”
Cómo se hace: - Identificar el supuesto compartido que todos asumen sin probar. - Articular evidencia o lógica que lo ponga en duda. - Reformular: la pregunta interroga el supuesto, no llena gap.
Resultado: preguntas transformativas, harder to publish, alto riesgo, alto impacto.
Ej.: “¿Y si educación + presencia armada destruye más capital humano del que crea por la migración forzada que induce?”
Advertencia
Implicación para tu tesis: una tesis de maestría puede vivir cómoda en gap-spotting (es legítimo y suficiente). Pero conoce qué tipo estás haciendo y declaralo en la introducción. Confundir los dos es la receta para reviewers irritados.
5 antipatrones de preguntas mal planteadas
Complementan los 9 errores de (Bairagi & Munot, 2019) · son síntomas observables que se detectan en 30 segundos:
☂️ 1. Pregunta-paraguas
Tan amplia que cualquier dato la confirma. “¿Cómo afecta la globalización al desarrollo?” → Test: ¿qué evidencia la refutaría? Si nada, no es pregunta.
🚫 2. Pregunta-tabú
Asume la respuesta en su redacción. “¿Por qué el modelo neoliberal fracasó en Colombia?” → Test: ¿podría la respuesta ser “no fracasó”?
♻️ 3. Pregunta-tautológica
La respuesta está implícita en la definición. “¿Los municipios con más pobreza tienen peor IPM?” (IPM mide pobreza).
📏 4. Pregunta-no-medible
Usa conceptos sin operacionalización posible. “¿La cultura política influye en el desarrollo?” → ¿Cómo mides “cultura política” con datos disponibles?
⚖️ 5. Pregunta-sin-contrafactual
No hay un “vs qué” implícito. “¿Funcionó Familias en Acción?” → ¿Funcionó comparado con qué? ¿Sin programa? ¿Con un control sintético?
Consejo
Test del “So what?”: si Sí y No llevan al mismo curso de acción, no es problema. Una buena pregunta tiene consecuencias según la respuesta.
🔧 Actividad S1 · Plantilla del iceberg
Importante
Sprint 1 · Actividad · 15 min · INDIVIDUAL. Llena las 4 capas con tu tema candidato. Foco fuerte en Capas 1 y 2 (luego Sprint 2 profundiza Capa 3). Al final: 3 voluntarios leen su Capa 2.
⏱️ S1·Act
15:00
| # | Capa | Pregunta-guía | Tu respuesta (1–2 líneas) |
|---|---|---|---|
| 1 | 🌊 Tema visible | ¿Qué titular o intuición me trajo aquí? | _______________ |
| 2 | 🏔️ Situación problemática | ¿Qué dato/fenómeno produce fricción? ¿En qué población, dónde, cuándo? | _______________ |
| 3 | 🧊 Mecanismos (ARV) | 3 actores · 3 relaciones · 3 variables observables (Sprint 2) | _______________ |
| 4 | 🔬 Problema investigable | Pregunta acotada con verbo de acción + población + período + posible método (Sprint 4) | _______________ |
Advertencia
Regla: si no nombras 3A·3R·3V en Capa 3, sigues en tema, no en problema. Capa 2 es la línea de flotación.
☕ Descanso · 20 min
☕
20:00
Volvemos 19:10. Trae café, lleva tu plantilla con Capas 1+2 lista.
Sprint 2 · ARV → DAG provisional
19:10 → 20:10 · ARV es la herramienta para excavar la Capa 3 del iceberg
⏱️ Bloque15 JC · 35 Act · 10 Desc
🎯 MetaMecanismos explícitos (3A·3R·3V) + DAG de 5 nodos
📦 ArtefactoTarjeta ARV + DAG por equipo
🧪 CheckpointDefender tu DAG: ¿qué controlar, qué no?
Nota
🌉 De S01: método económico es causal, no descriptivo (Mill → Popper → Friedman). ARV + DAG es cómo lo escribís sin tecnicismos antes de elegir método (U6).
Reglas para bajar de capa
🌊 → 🏔️ (visibilizar fricción)
- Reemplaza adjetivos por datos.
- Acota a población, lugar, período.
- Exige al menos una serie de tiempo o comparación.
🏔️ → 🧊 (abrir mecanismos)
- Identifica decisiones de cada actor.
- Hipotetiza dirección de cada relación.
- Pregúntate: ¿qué variable mide cada cosa?
🧊 → 🔬 (cerrar la pregunta)
- ¿Hay variación exógena disponible?
- ¿Qué literatura ya respondió piezas?
- ¿Cuál es el outcome principal y cómo se mide?
- Aplica FINER (lo veremos en Sprint 4).
Consejo
Heurística: una capa por sesión real de pensamiento. Resistir la tentación de saltar directo a Capa 4 — ahí nacen las preguntas frágiles.
ARV como heurística rápida
👥 Actores
- ¿Quiénes están involucrados?
- ¿Qué decisiones toman?
- ¿Qué incentivos tienen?
Ej: hogares, gobierno municipal, productores ilícitos, FARC-EP disidencias.
🔗 Relaciones
- ¿Qué hace que A afecte a B?
- ¿Qué dirección? ¿Qué intensidad?
- ¿Qué condicionalidades?
Ej: presencia armada → costos transacción → migración.
📊 Variables
- ¿Qué se puede observar/medir?
- ¿Con qué fuente?
- ¿Qué es proxy de qué?
Ej: hectáreas coca, IPM, NBI, índice de victimización.
Consejo
Ejercicio mental: si no puedes nombrar al menos 3 actores, 3 relaciones y 3 variables, no tienes todavía un problema de investigación — tienes un tema.
ARV → DAG provisional
| ARV | DAG (Pearl-style) |
|---|---|
| Actores | Nodos |
| Relaciones | Aristas dirigidas |
| Variables | Atributos del nodo |
→ ARV es el primer borrador de un DAG. La unidad U5 lo formaliza.
Cinelli, Forney & Pearl (2024) advierten: si no dibujas el DAG, no sabes qué controlar. “La decisión no es controlar por todo lo correlacionado; es seguir las reglas del grafo.” (Cinelli et al., 2024)
¿Qué hace un DAG por ti?
Un DAG (Directed Acyclic Graph) no es decoración — es una declaración pública y falsable de tus supuestos causales.
Qué te obliga a explicitar:
- Dirección de cada flecha (X → Y, no X — Y).
- Ausencias: qué NO está conectado es tan informativo como qué sí.
- Acíclico: no hay retroalimentación instantánea — si la hay, requiere otra herramienta (SEM dinámico, simultaneidad).
Qué no es un DAG:
- ❌ Un diagrama de flujo de procesos.
- ❌ Un mapa mental.
- ❌ Una correlación dibujada.
Importante
El error clásico — “Table 2 fallacy”: correr una regresión y reportar todos los coeficientes como si fueran efectos causales. Westreich & Greenland (2013) lo formalizaron; Cinelli et al. (2024) lo cuantificaron.
→ Sin DAG, no sabes qué controlar. → Con DAG, lo lees del grafo.
Consejo
Falsable = buena ciencia: si tus datos no son compatibles con las independencias condicionales que predice tu DAG, el DAG está mal. Test de implicaciones testables (Pearl, 2009).
Las 3 estructuras básicas del DAG
Toda relación causal se descompone en estos 3 patrones — y cada uno tiene una regla distinta sobre controlar:
🔗 Cadena (mediador)
X → Z → Y
Z transmite el efecto de X.
- ❌ NO controlar Z si buscas efecto total de X.
- ✅ SÍ controlar Z si buscas efecto directo (descomposición).
Ej: educación → salario → consumo.
🔱 Bifurcación (confounder)
X ← Z → Y
Z causa ambos → correlación espuria entre X e Y.
- ✅ SÍ controlar Z. Es el caso típico de “variable de control necesaria”.
Ej: educación de los padres ← X (educación hijo), Y (salario hijo).
⚡ Colisionador (collider)
X → Z ← Y
Z es efecto común de X e Y.
- ❌ NO controlar Z. Hacerlo abre un camino espurio (paradoja de Berkson, sesgo de selección).
Ej: talento → admisión ← belleza (en muestra de famosos).
Importante
Regla del back-door (Pearl): para estimar el efecto causal de X sobre Y, controla el set mínimo que (1) bloquee todos los caminos no causales entre X e Y, sin (2) tocar colliders ni descendientes de X.
DAG aplicado: Catatumbo
%%{init: {'flowchart': {'htmlLabels': false, 'curve': 'basis'}, 'themeVariables': {'fontSize': '22px', 'fontFamily': 'sans-serif'}}}%%
flowchart TB
    Z[Presencia armada]
    Z -->|aumenta| X[Economía ilícita]
    Z -->|aumenta| M[Migración forzada]
    X -->|reduce| INV[Inversión local]
    INV -->|reduce| Y[IPM]
    M -->|aumenta| Y
    X -. sospecha .-> Y
    style Z fill:#FAD7B3,stroke:#E67E22
    style X fill:#E6F4FA,stroke:#003D2C
    style Y fill:#003D2C,stroke:#003D2C,color:#fff
Lectura del grafo:
- X = tratamiento (economía ilícita).
- Y = outcome (IPM).
- Z = confounder (presencia armada) → bifurcación:
X ← Z → M → Y. Hay que controlarlo. - INV = mediador en el efecto de X → Y. Si controlas INV, mides solo el efecto directo.
Advertencia
Trampa frecuente: controlar por “todo lo que correlacione con IPM” incluye potenciales colliders → sesgo de magnitud impredecible.
Ejemplo trabajado en vivo · Boyacá
Advertencia
Situación: “Los créditos productivos del Banco Agrario aumentan, pero la productividad agrícola en Boyacá no.”
Filtro ARV
- 👥 Actores: hogares productores · Banco Agrario · intermediarios · gobierno municipal.
- 🔗 Relaciones: crédito → uso productivo → productividad. ¿O crédito → consumo → 0 productividad?
- 📊 Variables: monto crédito · uso declarado · rendimientos/ha · asistencia técnica.
Consejo
Pregunta candidata
¿Qué fracción del crédito productivo del Banco Agrario en Boyacá se traduce en aumentos verificables de productividad, y qué condiciones (asistencia técnica, insumos, tenencia) la modifican?
Verificar antes de avanzar: ¿datos? · ¿identificación? · ¿teoría? → Sprint 3.
🔧 Actividad S2 · ARV + DAG en equipos
Importante
Sprint 2 · Actividad · 35 min · EQUIPOS de 3–4. Elijan UNA plantilla del iceberg (de un integrante) y excaven la Capa 3 a fondo.
⏱️ S2·Act
35:00
Cronograma del equipo (35 min)
| Min | Tarea |
|---|---|
| 0–15 | Llenar ARV completo: 3 actores · 3 relaciones · 3 variables (con fuente plausible para cada V) |
| 15–25 | Dibujar DAG con ≥5 nodos, flechas dirigidas, marcar confounder candidato |
| 25–30 | Decisión: ¿qué controlar, qué NO? (regla del backdoor — preview U5) |
| 30–35 | Preparar defensa en 60 segundos del DAG |
Consejo
Entregable visible: foto del DAG en cartulina/whiteboard → suben a la carpeta de la unidad.
Advertencia
Trampa común: dibujar todas las flechas que se les ocurren. Un buen DAG escoge. Si todo está conectado con todo, no han pensado.
Share-back rápido (al cerrar): 2 equipos defienden su DAG en 60s.
☕ Descanso · 10 min
☕
10:00
Volvemos 20:10. Dejen su DAG visible — lo retomamos en Sprint 3.
Sprint 3 · La revolución de IA
20:10 → 21:10 · El marco IA² aterriza sobre tu problema
⏱️ Bloque35 JC · 15 Act · 10 Desc
🎯 MetaPrompt estructurado como competencia + audit log activo
📦 ArtefactoPrompt enviado + audit log inicial
🧪 CheckpointDetectar ≥1 cita alucinada
Nota
🌉 De S01: marco IA² (tú sos el investigador, la IA es tu palanca) + AIAS 5 modos + audit log obligatorio. Aquí lo estrenan en modo AIAS-3 Collaboration sobre su pregunta v1.
La revolución
Versión navegable y a pantalla completa también en la página de la unidad.
La diferencia entre “usar IA” y “usar IA bien”
Prompt típico de estudiante
“ChatGPT, ayúdame con mi pregunta de investigación sobre pobreza.”
Problemas: - No da contexto. - No declara rol. - No define output esperado. - No proporciona constraints.
Resultado: respuesta genérica, no usable.
Prompt estructurado
“Actúa como economista aplicado experto en pobreza rural. Tengo esta situación: [pega ARV]. Mi pregunta candidata es [pega]. Critica: (1) ¿Es identificable causalmente? Si sí, ¿con qué método? Si no, ¿qué falta? (2) ¿Hay literatura en los últimos 5 años? Cita 3 papers (verificaré en Scopus). (3) Sugiere 3 reformulaciones más respondibles, cada una con sus tradeoffs.”
Advertencia
Reglas duras del curso: 1. Toda cita generada por IA se verifica en fuente original — (Buchanan et al., 2024) documenta >30% de citas alucinadas en economía. 2. Toda decisión metodológica final es del estudiante. 3. Toda interacción se documenta en el audit log de la entrega.
🔧 Actividad S3 · Tu primer prompt crítico
Importante
Sprint 3 · Actividad · 15 min · INDIVIDUAL. Toma tu plantilla iceberg + ARV de equipos. Envía UN prompt estructurado a Claude/ChatGPT. Captura screenshot del output.
⏱️ S3·Act
15:00
Patrón del curso · 7 secciones obligatorias: ROL · CONTEXTO · INSUMO · TAREA · FORMATO · CRÍTICA · AUDIT LOG. Cópienlo, péguenlo en su modelo y editen los {placeholders}.
Prompt-ready · Crítica de pregunta candidata
Consejo
Modo AIAS: 3 — Collaboration · Cuándo: después de tener iceberg + ARV + pregunta v1 · Modelo: Claude Sonnet 4.6 o GPT-4o (triangular con el otro).
[ROL] Eres economista aplicado senior, revisor de AEJ: Applied Economics. Tu trabajo NO es animarme; es identificar las debilidades de identificación, medición y relevancia que un referee marcaría.
[CONTEXTO] Curso EC0744 · MAE EAFIT · Marco IA². Aplicas: iceberg 4 capas, ARV (3-3-3), FINER (Hulley et al., 2013), reglas back-door (Cinelli et al., 2024; Pearl & Mackenzie, 2018) y caza de alucinaciones (Buchanan et al., 2024).
[INSUMO] Voy a pegar: (a) {iceberg_capas_1_a_4} · (b) {ARV: 3 actores, 3 relaciones, 3 variables} · (c) {pregunta_v1} · (d) {contexto_pais_periodo}.
[TAREA] 1. Ubica la pregunta v1 en una capa del iceberg (1-4) y justifica. 2. Mapea qué pieza del ARV está incompleta o sin fuente verificable. 3. Califica F-I-N-E-R de 1-5 con una línea de justificación por dimensión. 4. Cita 3 papers de los últimos 5 años — si no estás 100% seguro del DOI/año, declara INCERTIDUMBRE antes de la cita. NO inventes. 5. Propón 3 reformulaciones v2 con verbo·objeto·población·período·método, cada una con su trade-off. 6. Cierra en modo crítica: ¿qué supuesto causal estoy asumiendo sin justificar?
[FORMATO DE SALIDA] Tabla markdown:
# | Capa actual | ARV gap | FINER (F·I·N·E·R) | Pregunta v2 candidata | Trade-off |
Más una sección final ## Citas (3 ítems con marcador [verificable] o [INCERTIDUMBRE]).
[CRÍTICA] Antes de cerrar responde: (i) ¿cuál es la mayor debilidad de tu propio output? (ii) ¿qué NO alcanzaste a verificar? (iii) ¿qué cita estás 100% seguro vs cuál podría ser alucinación?
[AUDIT LOG] Imprime al final:
☕ Descanso · 10 min
☕
10:00
Volvemos 21:10. Lleguen con el screenshot del output de la IA — lo usamos en Sprint 4.
Sprint 4 · Pregunta v1 → v2
21:10 → 21:40 · 30 minutos · 100% actividad · Cierre integrado
⏱️ Bloque30 Act · sin descanso · cierre directo
🎯 MetaPregunta v2 con verbo·objeto·población·período·método
📦 ArtefactoPregunta v2 + audit log completo + 3 citas verificadas
🧪 CheckpointPasa el checklist 4+3 y FINER
Nota
🌉 De S01: 5 tipologías de pregunta + creatividad como margen del investigador. Hoy se cristaliza en una pregunta v2 que entra a Hito H1 (cierra en U3).
🔧 Actividad S4 · Cronograma de 30 min
Importante
Sprint 4 · Actividad continua · 30 min · INDIVIDUAL. Cuatro micro-fases cronometradas. Al final, suben pregunta v2 + audit log a la carpeta de la unidad.
1·v105:00
2·Verif10:00
3·v210:00
4·Peer05:00
| Fase | Min | Tarea | Recurso |
|---|---|---|---|
| 1 | 5 | Redactar Pregunta v1 con la plantilla de Anatomía | Sprint 1 · “Anatomía” |
| 2 | 10 | Verificar las 3 citas que dio la IA en Sprint 3 (Scopus/Scholar). Marcar reales / alucinadas | Buchanan 2024 |
| 3 | 10 | Reformular a Pregunta v2 aplicando FINER + checklist 4+3 | Sprint 1 · “Ejemplos v1→v4” |
| 4 | 5 | Peer-check: par lee tu v2 con las 8 características + 9 errores de Bairagi; ¿pasa? | Sprint 1 · “Las 8 características” |
Advertencia
Audit log obligatorio: modelo + prompt literal + ¿cuántas citas reales? + qué tomaron / qué rechazaron de la IA y por qué. Sin audit log, la entrega no se evalúa.
Checklist de calidad — 4 + 3
✅ Definición del problema (4)
- Recursos: ¿es abordable con tiempo, datos, experiencia y financiamiento disponibles?
- Objetividad: ¿usa términos neutros, no juicios? (Ej: “subvencionados” ≠ “sobrepagados”.)
- Inteligibilidad: ¿alguien externo al proyecto la entiende sin contexto adicional?
- Justificación: ¿la explicación deja claro por qué importa el objetivo?
✍️ Pautas de escritura (3)
- Precisión sobre ambigüedad — palabras exactas.
- Simplicidad sobre divagación — frases directas, balance con suficiente detalle.
- Sin promoción ni juicio — imparcial, evidencia primero.
Consejo
Revisión externa: todo borrador de problema debe ser leído por al menos un par antes de fijarlo. La auto-revisión está sesgada por dotación.
“La descripción escrita del problema es la única evidencia creíble de que se ha logrado una comprensión clara de la pregunta.” — (Ethridge, 2004) cap. 5.
→ Para el peer-check de la Fase 4 del cronograma, usen también las 8 características de Bairagi (Sprint 1) y los 9 errores típicos. Si tu par detecta ≥ 2 errores, vuelves a redactar.
Conexión con la siguiente unidad
Tu pregunta de investigación determina:
- U3 — Objetivos: la descomponemos en pasos verificables (mini-PAP).
- U4 — Lit review: PRISMA buscando literatura específica a tu pregunta.
- U5 — Marco teórico: el DAG que la formaliza.
- U6 — Métodos: la identificación que la responde.
- U7 — Comunicación: cómo la cuentas.
Consejo
Una hora gastada aquí en formular bien la pregunta vale 100 horas más adelante.
Volvérsela a cambiar a las 4 semanas duplica el costo del proyecto.
Reglas duras del Sprint 4
Advertencia
Reglas (las mismas del curso):
- No copies el output de IA como tu pregunta. Tomas insumos, tú decides.
- Verifica toda cita. Si Buchanan et al. 2024 reportó >30%, asume que la primera pasada de tu IA tiene 1-2 citas falsas.
- Documenta el proceso. El audit log forma parte de la entrega.
→ Marco operacional: AI Assessment Scale (AIAS) — declara nivel 1-5 según uso. (Perkins et al., 2024)
Cierre
21:40 → 22:00 · Síntesis · Q&A · Pre-trabajo S3
Lo que se llevan
Conceptual: - Diferencia tema / situación / problema. - ARV como heurística rápida. - ARV → DAG (preview U5). - FINER como filtro de viabilidad.
Operativo: - Plantilla de pregunta. - Prompt structurado para refinamiento. - Workflow IA + verificación.
Crítico: - LLMs alucinan citas (Buchanan et al. 2024). - p-hacking es diferencial por método (Brodeur et al. 2020). - Prompt engineering es competencia enseñable (Woo et al. 2024).
Próximo: - U3 — descomponer la pregunta en objetivos verificables (mini-PAP).
Pregunta de cierre
¿Cuál es la diferencia entre tu pregunta v1 y tu pregunta v2 — y qué les dice eso sobre lo que aprendieron en estas 5.5 horas?
Lecturas mínimas para mañana
Nota
Para Sesión 3 (mañana): 1. (Bairagi & Munot, 2019) cap. 2 sec. 2.7–2.8 — 10 páginas · el checklist operativo. Ficha: bairagi2019_cap2.md. 2. (Korinek, 2023) sec. 3.1 (ideación) — 8 páginas. Ficha: Korinek2023.md. 3. (Ludwig & Mullainathan, 2024) intro + caso aplicado — 15 páginas. 4. (Woo et al., 2024) abstract + sección de resultados — 5 páginas.
Si tienen 30 min más: - (Messeri & Crockett, 2024) sección “AI as Oracle” (lectura crítica). Ficha: MesseriCrockett2024.md.
Consejo
Pre-trabajo activo: lleguen mañana con su pregunta v2 + audit log + 3 papers verificados.
Acemoglu, D. (2025). The Simple Macroeconomics of AI. Economic Policy, 40(121), 13-58. https://doi.org/10.1093/epolic/eiae042
Alvesson, M., & Sandberg, J. (2011). Generating Research Questions Through Problematization. Academy of Management Review, 36(2), 247-271. https://doi.org/10.5465/amr.2009.0188
Bairagi, V., & Munot, M. V. (2019). Research Methodology: A Practical and Scientific Approach. CRC Press / Taylor & Francis.
Brynjolfsson, E., Li, D., & Raymond, L. R. (2025). Generative AI at Work. Quarterly Journal of Economics, 140(2), 889-942. https://doi.org/10.1093/qje/qjae044
Buchanan, J., Hill, S., & Shapoval, O. (2024). ChatGPT Hallucinates Non-existent Citations: Evidence from Economics. The American Economist, 69(1), 80-87. https://doi.org/10.1177/05694345231218454
Cinelli, C., Forney, A., & Pearl, J. (2024). A Crash Course in Good and Bad Controls. Sociological Methods and Research, 53(3), 1071-1104. https://doi.org/10.1177/00491241221099552
Eloundou, T., Manning, S., Mishkin, P., & Rock, D. (2024). GPTs are GPTs: Labor Market Impact Potential of LLMs. Science, 384(6702), 1306-1308. https://doi.org/10.1126/science.adj0998
Ethridge, D. E. (2004). Research Methodology in Applied Economics: Organizing, Planning and Conducting Economic Research (2nd ed., p. 248). Wiley-Blackwell.
Heilmeier, G. H. (1992). Some Reflections on Innovation and Invention (Winter 1992; pp. 12-16). National Academy of Engineering — The Bridge.
Hernández-Sampieri, R. (2010). Metodología de la Investigación: Las Rutas Cuantitativa, Cualitativa y Mixta (p. 654). McGraw Hill.
Hulley, S. B., Cummings, S. R., Browner, W. S., Grady, D. G., & Newman, T. B. (2013). Designing Clinical Research (4th ed.). Lippincott Williams & Wilkins.
Korinek, A. (2023). Generative AI for Economic Research: Use Cases and Implications for Economists. Journal of Economic Literature, 61(4), 1281-1317. https://doi.org/10.1257/jel.20231736
Ludwig, J., & Mullainathan, S. (2024). Machine Learning as a Tool for Hypothesis Generation. Quarterly Journal of Economics, 139(2), 751-827. https://doi.org/10.1093/qje/qjad055
Messeri, L., & Crockett, M. J. (2024). Artificial Intelligence and Illusions of Understanding in Scientific Research. Nature, 627(8002), 49-58. https://doi.org/10.1038/s41586-024-07146-0
Pearl, J., & Mackenzie, D. (2018). The Book of Why: The New Science of Cause and Effect. Basic Books.
Perkins, M., Furze, L., Roe, J., & MacVaugh, J. (2024). The AI Assessment Scale (AIAS): A Framework for Ethical Integration of Generative AI in Educational Assessment. Journal of University Teaching and Learning Practice, 21(6). https://doi.org/10.53761/q3azde36
Woo, D. J., Susanto, H., Yeung, C. H., Guo, K., & Fung, A. K. Y. (2024). Effects of a Prompt Engineering Intervention on Undergraduate Students’ AI Self-Efficacy, AI Knowledge and Prompt Engineering Ability: A Mixed Methods Study. British Educational Research Journal. https://doi.org/10.1002/berj.70087
EC0744 · Seminario de Investigación Aplicada Universidad EAFIT · Escuela de Finanzas, Economía y Gobierno 2026-1